03 Von Greenfield zu Brownfield: KI-gestützte Entwicklung in bestehenden Codebasen
March 2026 (9811 Words, 55 Minutes)
1. Einführung
Willkommen zurück in Woche 2 von Akt I — Erfahrung. In der letzten Sitzung haben Sie drei grundlegend verschiedene Ansätze für die KI-gestützte Entwicklung kennengelernt — vom einfachen Copy-Paste-Prompt bis hin zu einem professionellen SDLC-Workflow mit Anforderungen, Tests, Git-Disziplin und einem KI-Tagebuch. Sie wurden losgeschickt, um die Stack Overflow Challenge mit Ansatz 3 zu wiederholen. Inzwischen haben Sie diesen zweiten Durchgang versucht: ein Projekt mit uv aufsetzen, Anforderungen vor dem Code schreiben, Tests vor der Implementierung erstellen, bei jedem Schritt committen und Tagebucheinträge parallel zu jedem Prompt-Zyklus pflegen.
Bevor wir weitermachen, müssen wir diesen Kreis schließen. Dann betreten wir vollkommen neues Terrain.
In den Vorlesungen 1 und 2 war jede Codezeile, die Sie berührt haben, Code, den Sie geschrieben haben. Sie haben die Dateinamen, die Verzeichnisstruktur, die Architektur gewählt. Sie hatten die volle Kontrolle. Das nennt man Greenfield-Entwicklung — Bauen auf einer leeren Leinwand.
Heute stellen wir die Frage: Was passiert, wenn die Leinwand nicht leer ist?
2. Den Kreis schließen: Stack Overflow Challenge Runde 2
2.1 Das Feedback-Quiz
Wir beginnen mit einem kurzen Feedback-Quiz — dasselbe Format wie in Vorlesung 1, aber mit Fokus auf dem Vergleich Ihrer beiden Versuche. Öffnen Sie den Google-Forms-Link auf der Kursseite und nehmen Sie sich 5-8 Minuten für die Beantwortung.
Die zentralen Fragen:
- Welchen Ansatz haben Sie verwendet? Haben Sie Ansatz 3 strikt befolgt, oder haben Sie Ansätze kombiniert?
- Hat es sich verbessert? Auf einer Skala von 1-5: War Ihr zweiter Versuch besser als der erste?
- Anzahl der Iterationen: Wie viele Prompts haben Sie gebraucht? Vergleichen Sie mit Ihrem ersten Versuch.
- KI-Tagebuch-Erfahrung: Hat sich das Führen des Tagebuchs wie Overhead angefühlt, oder wurde es nützlich?
- Zuversicht bei unbekanntem Code: Wie zuversichtlich sind Sie, KI-Werkzeuge in einer Codebasis einzusetzen, die Sie NICHT geschrieben haben?
Die letzte Frage ist besonders wichtig. Merken Sie sich Ihre Antwort — wir kommen am Ende dieser Vorlesung darauf zurück.
2.2 Was wir erwarten
Wenn wir die aggregierten Ergebnisse betrachten, sollten bestimmte Muster erkennbar werden:
Die Iterationszahlen werden wahrscheinlich sinken. Ansatz 3 verlagert das Denken nach vorne: Sie schreiben Anforderungen vor dem Code, Tests vor der Implementierung. Jeder Prompt ist eingegrenzt und spezifisch. Im Vergleich zu einem monolithischen “Erstelle mir ein Stack-Overflow-Diagramm”-Prompt, der eine Kaskade von Korrekturen auslöst, erfordert der strukturierte Ansatz in der Regel weniger Gesamtiterationen — obwohl er mehr einzelne Prompt-Schritte hat.
Die Zuversicht wird wahrscheinlich steigen. Studierende, die einem strukturierten Prozess gefolgt sind, berichten von höherer Zuversicht in ihre Ergebnisse. Das liegt nicht daran, dass die KI besseren Code produziert hätte — sondern daran, dass der Prozess Prüfpunkte bot. Wenn Ihre Tests bestehen, wissen Sie etwas. Wenn Ihr Git-Log einen sauberen Verlauf zeigt, können Sie nachvollziehen, was passiert ist. Die Struktur macht das Ergebnis überprüfbar.
Das Tagebuch wird polarisieren — aber die Reibung hat sich verlagert. In Runde 1 lautete die Beschwerde: “Tagebucheinträge zu schreiben ist mühsam.” In Runde 2 geht der Eintrag selbst schnell — es ist nur Ihr Prompt-Text und einige Metadatenfelder. Die eigentliche Reibung liegt nicht mehr beim Tagebuchinhalt, sondern bei der Commit-Disziplin drum herum: die Arbeit so zu strukturieren, dass jede KI-Interaktion einen sauberen, nachvollziehbaren Commit erzeugt. Manche von Ihnen werden das als einengend empfinden — “Ich will einfach coden, nicht über Commit-Granularität nachdenken.” Diese Reaktion ist es wert, untersucht zu werden. In einer gemeinsamen Codebasis mit Dutzenden von Mitwirkenden ist Commit-Disziplin kein Overhead — sie ist Kommunikation. Später in dieser Vorlesung stellen wir einen spezifischen Tagebuch-Workflow vor, der für kollaborative Brownfield-Arbeit konzipiert ist.
Nicht alle werden Ansatz 3 strikt verwendet haben. Einige von Ihnen haben Ansätze kombiniert — vielleicht strukturierte Zerlegung für die Recherchephase, professionelles SDLC für die Implementierungsphase. Das ist in Ordnung. Es ging nie darum, einem starren Skript zu folgen. Es ging darum zu bemerken, dass die Art, wie Sie mit der KI interagieren, beeinflusst, was Sie erhalten.
2.3 Noch etwas: Eine CLAUDE.md für Ihr Challenge-Repository
Bevor wir die Stack Overflow Challenge hinter uns lassen: Öffnen Sie das Referenz-Repository und schauen Sie ins Stammverzeichnis. Sie finden dort eine neue Datei: CLAUDE.md. Nehmen Sie sich 30 Sekunden, um sie zu lesen.
Sie umfasst etwa 45 Zeilen. Sie teilt einem KI-Coding-Assistenten mit, worum es in diesem Projekt geht, wie man es ausführt, wie der Code organisiert ist und wie die Tests funktionieren. Daneben finden Sie in .github/copilot-instructions.md denselben Inhalt, formatiert für GitHub Copilot. Zwei Dateien, derselbe Zweck — egal welches KI-Werkzeug Sie nutzen, es nimmt den Projektkontext automatisch auf.
Für ein Projekt dieser Größe — vier Quelldateien, 250 Zeilen Code — ist diese Datei fast unnötig. Sie könnten den gesamten Quellcode in einen Prompt einfügen und die KI würde ihn verstehen. Die CLAUDE.md fügt etwa 500 Token Kontext hinzu. Das ist ein kurzer Absatz, in einem Kontextfenster, das Hunderttausende von Token fasst.
Behalten Sie diesen Gedanken. Später in dieser Vorlesung werden Sie eine CLAUDE.md für ein Projekt mit über 10.000 Zeilen Code sehen. Diese ist über 600 Zeilen lang — und sie ist unverzichtbar, nicht optional. Dasselbe Konzept. Völlig andere Dimension.
Die Frage, die Sie sich stellen sollten: Ab welchem Punkt wird ein Projekt groß genug, dass eine CLAUDE.md aufhört, ein Nice-to-have zu sein, und zur Notwendigkeit wird? Das ist eine der Fragen, die diese Vorlesung beantwortet.
2.4 Die Frage, die diese Vorlesung einleitet
Schauen Sie sich nun die Ergebnisse der Zuversichtsfrage an: “Wie zuversichtlich sind Sie, KI-Werkzeuge in einer Codebasis einzusetzen, die Sie NICHT geschrieben haben?”
Wenn das Muster zutrifft, haben viele von Ihnen dies niedriger bewertet als Ihre allgemeine Zuversicht. Und das ist eine ehrliche, zutreffende Einschätzung. Alles, was Sie bisher gemacht haben — den Stack-Overflow-Plot, die Tagebucheinträge, das strukturierte Prompting — war Greenfield. Sie haben von einem leeren Verzeichnis aus gestartet. Sie haben jede Entscheidung getroffen.
Aber so sehen die meisten Software-Jobs nicht aus.
3. Die Brownfield-Realität
3.1 Wie Entwickler:innen tatsächlich ihre Zeit verbringen
Hier ist eine unbequeme Statistik: 60-80 % des professionellen Software-Entwicklungsaufwands fließen in die Wartung und Weiterentwicklung bestehender Systeme, nicht in den Bau neuer. Diese Zahl taucht konsistent in Branchenstudien auf — von klassischer Software-Engineering-Forschung (Pressman, Sommerville) bis hin zu modernen Berichten wie dem DORA State of DevOps und den JetBrains Developer Ecosystem Surveys.
Es wird noch konkreter. Eine Studie von Minelli, Mocci und Lanza aus dem Jahr 2015 — “I Know What You Did Last Summer”, vorgestellt auf der IEEE ICPC — verfolgte Entwickleraktivität über 740 Sitzungen und mehr als 200 Stunden IDE-Nutzung. Ihr Ergebnis: Etwa 70 % der Entwicklungszeit entfallen auf das Programmverstehen — Code lesen, Aufrufhierarchien navigieren und mentale Modelle davon aufbauen, wie bestehende Komponenten zusammenwirken. Frühere Arbeiten von LaToza, Venolia und DeLine bei Microsoft Research (ICSE 2006) fanden ein ähnliches Muster, wobei Entwickler:innen berichteten, dass das Verstehen von bestehendem Code ihre tägliche Arbeit dominierte. Das konsistente Ergebnis über ein Jahrzehnt Forschung hinweg: Die primäre Entwicklertätigkeit ist nicht das Schreiben — es ist das Lesen.
(Ob KI-Werkzeuge dieses Verhältnis verschieben werden — indem sie das Verstehen beschleunigen oder mehr Erstfassungen von Code generieren — ist eine offene Frage. Frühe Daten aus den GitHub Copilot-Studien von 2024 deuten darauf hin, dass Entwickler:innen mit KI-Unterstützung Aufgaben schneller erledigen, aber es ist zu früh um zu wissen, wie sich dies auf das Lesen-vs-Schreiben-Verhältnis in Brownfield-Umgebungen auswirkt. Wir werden diese Frage im Laufe des Kurses immer wieder aufgreifen.)
Überlegen Sie, was das für Ihre Karriere bedeutet. Wenn Sie ein Praktikum beginnen, in ein Abschlussarbeitsprojekt einsteigen oder Ihre erste Stelle antreten, werden Sie nicht von Grund auf neu bauen. Sie werden eine Codebasis erben. Jemand anderes hat sie geschrieben — möglicherweise viele Menschen, über viele Jahre. Jemand anderes hat die Architektur gewählt, die Namenskonventionen, das Test-Framework. Jemand anderes hat entschieden, welche Bibliothek HTTP-Anfragen behandelt und welches ORM mit der Datenbank kommuniziert. Ihre Aufgabe ist es, zu verstehen, was bereits da ist, und es zu verbessern, ohne das zu zerstören, was funktioniert.
Das nennt man Brownfield-Entwicklung — Arbeiten in einer bestehenden Codebasis mit bestehenden Einschränkungen, bestehenden Konventionen und bestehenden Nutzern, die darauf angewiesen sind, dass sich der Code so verhält, wie er es derzeit tut.
3.2 Was sich ändert, wenn der Code bereits existiert
Der Wechsel von Greenfield zu Brownfield verändert alles an Ihrer Arbeitsweise — und an der Art, wie Sie KI-Werkzeuge einsetzen. Gehen wir die fünf wichtigsten Unterschiede durch.
3.2.1 Kontext wird entscheidend
In der Stack Overflow Challenge startete die KI mit demselben leeren Blatt wie Sie. Sie beschrieben, was Sie wollten, und sie generierte Code. Der Kontext war klein: einige Anforderungen, vielleicht ein Referenzbild und was immer Sie bis dahin geschrieben hatten.
In einer bestehenden Codebasis gibt es eine massive Asymmetrie: Sie können 10.000 Zeilen Code in Ihrem Editor durchblättern, aber die KI sieht nichts davon, es sei denn, Sie geben ihr Zugriff. Selbst mit modernen großen Kontextfenstern (100.000+ Token) liefert das Einfügen eines ganzen Projekts in einen Prompt schlechtere Ergebnisse als die Bereitstellung von strukturiertem, kuratiertem Kontext. Die KI muss nicht jede Datei sehen — sie muss die Architektur, die Konventionen und den spezifischen Bereich verstehen, in dem Sie arbeiten.
Genau dieses Problem lösen Projektanweisungsdateien — die CLAUDE.md- und .github/copilot-instructions.md-Dateien, die wir am Ende von Vorlesung 2 besprochen haben. In jener Vorlesung erschien CLAUDE.md als eine Möglichkeit, sich nicht ständig zu wiederholen: Sie haben Ihr Tagebuchformat und Ihre Commit-Konventionen einmal kodiert, und die KI hat sie in jeder Sitzung befolgt. Das war CLAUDE.md als Lösung für ein Skriptproblem — die Eliminierung von Boilerplate in einem kleinen, in sich geschlossenen Workflow.
Jetzt löst dieselbe Datei ein viel schwierigeres Problem: der KI eine strukturierte Karte eines gesamten Projekts zu geben. Eine Brownfield-CLAUDE.md kodiert die Architektur, die Coding-Konventionen, die Testmuster und — wie wir im Abschnitt Definition of Done unten sehen werden — die Qualitätstore des Projekts selbst. Wenn die Definition of Done besagt “alle bestehenden Tests bestehen, neuer Code hat Tests, Dokumentation ist aktualisiert”, dann können diese Kriterien direkt in der CLAUDE.md stehen und verwandeln eine menschliche Checkliste in maschinenlesbare Anweisungen. Die KI weiß nicht nur, wie das Projekt aussieht — sie weiß, was “fertig” in diesem Projekt bedeutet.
Beachten Sie die Progression: CLAUDE.md wurde für Skriptautomatisierung eingeführt, bietet jetzt Projektkontext und wird bald Qualitätstore kodieren, die die KI automatisch prüft. Das ist keine zufällige Wiederholung — es ist dasselbe Konzept, das sich mit jedem Einsatz vertieft. Wir werden heute erstmals eine Projektanweisungsdatei verwenden, und am Ende dieser Vorlesung werden Sie genau sehen, wie sie mit der erweiterten Definition of Done zusammenhängt.
3.2.2 Tests sind Ihr Sicherheitsnetz
In der Stack Overflow Challenge waren Tests Teil des SDLC-Workflows — Sie haben sie geschrieben, weil Ansatz 3 es so vorsah, und weil sie halfen, Ihre Implementierung zu verifizieren. Sie waren aspirativ.
In einer bestehenden Codebasis sind Tests existenziell. Die bestehende Testsuite ist ein Vertrag: Sie kodiert das erwartete Verhalten des Systems. Wenn Sie Code ändern, sagt Ihnen die Testsuite, ob Sie diesen Vertrag eingehalten oder gebrochen haben. “Alle Tests bestehen” ist kein Nice-to-have — es ist die Mindestanforderung für jede Änderung, die Sie vornehmen.
Das verändert Ihren Workflow grundlegend. Im Greenfield schreiben Sie vielleicht erst Code und dann Tests (oder nie). Im Brownfield ist pytest Ihr erster und letzter Befehl. Führen Sie ihn aus, bevor Sie irgendetwas ändern, um die Baseline zu bestätigen. Führen Sie ihn nach jeder Änderung aus, um zu bestätigen, dass Sie den Vertrag nicht gebrochen haben.
3.2.3 Lesen übertrumpft Schreiben
Im Greenfield ist die primäre Tätigkeit das Schreiben von neuem Code. Im Brownfield ist die primäre Tätigkeit das Verstehen von bestehendem Code.
Bevor Sie eine Funktion ändern können, müssen Sie beantworten: Was tut sie? Wer ruft sie auf? Was passiert, wenn ich den Rückgabetyp ändere? Welche Annahmen trifft sie über ihre Eingaben? Gibt es Dokumentation — und ist diese Dokumentation korrekt?
KI-Werkzeuge können dabei helfen. “Erkläre diese Funktion”, “Was ruft diese Methode auf?”, “Was verifiziert dieser Test?” — das sind Fragen, die KI schnell beantworten kann. Aber hier ist der entscheidende Vorbehalt: Die Erklärung der KI ist eine Hypothese, kein Fakt. Sie beschreibt möglicherweise, was der Code “wahrscheinlich” tut, basierend auf Namenskonventionen, statt was er tatsächlich tut. Sie kann Seiteneffekte, implizite Zustandsmutationen oder nicht offensichtlichen Kontrollfluss übersehen. Sie müssen die Erklärung der KI immer am tatsächlichen Code verifizieren.
3.2.4 Die Definition of Done erweitert sich
In der Stack Overflow Challenge bedeutete “fertig”: Der Plot sieht richtig aus und der Code läuft. Das war ausreichend für eine in sich geschlossene Übung.
In einem realen Projekt bedeutet “fertig” viel mehr:
| Kriterium | Greenfield (SO Challenge) | Brownfield (Bestehendes Projekt) |
|---|---|---|
| Tests | Optional, aspirativ | Alle bestehenden Tests bestehen + neue Tests für neuen Code |
| Coverage | Nicht gemessen | Gemessen, keine Regressionen, neuer Code abgedeckt |
| Performance | Nicht gemessen | Keine Verschlechterung; Benchmark falls relevant |
| Code Review | Nicht zutreffend | PR geprüft, Beschreibung korrekt |
| Dokumentation | Nicht zutreffend | Aktualisiert, wenn sich das Verhalten geändert hat |
| Konventionen | Sie haben sie gewählt | Sie befolgen sie |
| Git-Workflow | Frei wählbar | Branch, Commit, PR, Merge |
| KI-Tagebuch | Prompts aufgezeichnet | Prompts aufgezeichnet + Ausgaben verifiziert |
Das ist keine Bürokratie. Jeder Punkt in der Brownfield-Spalte existiert, weil irgendwann irgendwo jemand eine Änderung ausgeliefert hat, die die Produktion kaputt gemacht hat, und sich wünschte, noch eine Sache mehr geprüft zu haben. Die erweiterte Definition of Done ist das Narbengewebe realer Software-Teams.
Beachten Sie die letzte Zeile: das KI-Tagebuch. In Vorlesung 2 haben wir eine strikte Disziplin eingeführt — ein Commit pro Prompt, sodass jede KI-Interaktion ein entsprechendes Artefakt in der Git-Historie hat. Diese Disziplin war fürs Lernen konzipiert: Sie zwingt Sie, jede Interaktion wahrzunehmen, jede Ausgabe zu beurteilen und einen nachvollziehbaren Nachweis darüber aufzubauen, wie die KI zu Ihrer Arbeit beigetragen hat.
Aber hier liegt die Spannung: Der Git-Workflow eines realen Projekts kann ganz anders aussehen. Viele Teams squashen Commits vor dem Merge eines PR, sodass Ihre zwanzig sorgfältigen Tagebuch-Commits zu einem einzigen Merge-Commit werden. Manche Teams erzwingen Conventional Commits (feat:, fix:, chore:), bei denen “diary entry” kein gültiges Präfix ist. Die Ein-Commit-pro-Prompt-Strategie kann, wörtlich genommen, eine unübersichtliche Git-Historie erzeugen, die mit den Konventionen des Projekts kollidiert.
Das ist kein Widerspruch — es ist ein Spektrum, das Sie jetzt bewusst navigieren können. Am einen Ende: nach jedem einzelnen Prompt committen, einschließlich trivialer (“Tippfehler korrigiert”, “Import-Reihenfolge angepasst”). Das maximiert die Nachvollziehbarkeit, aber überfrachtet die Historie. Am anderen Ende: frei mit KI über viele Prompts hinweg arbeiten und nur committen, wenn Sie einen bedeutsamen Meilenstein erreichen, wobei die Schlüsselinteraktionen in einer separaten Tagebuchdatei festgehalten werden. Das ergibt eine sauberere Historie, aber eine schwächere Prompt-Artefakt-Korrespondenz.
Für diesen Kurs bleiben wir näher am strikten Ende — weil der Lernwert der Nachverfolgung Ihrer KI-Interaktionen die Git-Ästhetik überwiegt. Aber Sie sollten sich bewusst sein, dass Sie sich in einem Produktionsprojekt anpassen würden. Der Zweck des Tagebuchs ist es, Ihre KI-Nutzung sichtbar und überprüfbar zu machen. Wie Sie das erreichen — durch granulare Commits, ein separates Tagebuchdokument oder eine Mischform — ist eine Entscheidung, die Sie basierend auf den Konventionen des Projekts treffen. Das Wichtige ist, dass die Korrespondenz in irgendeiner Form existiert, nicht dass sie einem starren Format folgt.
3.2.5 Coding-Konventionen sind vorgegeben
In der Stack Overflow Challenge haben Sie den Stil festgelegt. Sie haben snake_case oder camelCase gewählt, entschieden, wie Imports organisiert werden, Ihr eigenes Commit-Message-Format gewählt. Jede Konvention war Ihre.
In einem bestehenden Projekt sind die Konventionen bereits etabliert. Die Codebasis verwendet ein bestimmtes Benennungsmuster. Imports folgen einer bestimmten Reihenfolge. Docstrings verwenden ein bestimmtes Format (Google-style, NumPy-style, reStructuredText). Der Git-Workflow folgt einem bestimmten Branching-Modell. Ihre Änderungen müssen diesen Konventionen entsprechen — auch wenn Sie etwas anderes bevorzugen.
Hier interagieren KI-Werkzeuge auf besonders interessante Weise mit Konventionen. Ohne expliziten Kontext folgt die KI generischen Python-Konventionen (PEP 8), die möglicherweise nicht zum tatsächlichen Stil des Projekts passen. Mit einer CLAUDE.md, die spezifiziert “dieses Projekt verwendet Google-style Docstrings und sortiert Imports mit isort”, ist der KI-generierte Code deutlich wahrscheinlicher konsistent mit der bestehenden Codebasis. Aber — und das ist wichtig — es ist nicht garantiert. Bei der Vorbereitung dieses Kurses enthielt KI-generierter Code PEP-8-Verstöße, obwohl eine umfassende CLAUDE.md die Linting-Konventionen explizit spezifizierte. Projektanweisungsdateien verbessern die Einhaltung; sie erzwingen sie nicht. Deshalb verwenden reale Projekte automatisiertes Linting und CI-Checks als zweites Sicherheitsnetz — und Sie werden beides heute in Aktion sehen.
3.3 KI im Brownfield: Nützlicher UND gefährlicher
Hier ist die ehrliche Bestandsaufnahme von KI-Werkzeugen in bestehenden Codebasen. Sie werden nützlicher, weil es mehr Code zu verstehen gibt, mehr Kontext zu navigieren, mehr Muster zu befolgen. Aber sie werden auch gefährlicher, weil es mehr zu zerstören gibt, mehr Konventionen zu verletzen und mehr Annahmen falsch zu treffen.
Wo KI im Brownfield glänzt:
- Code-Erklärung: “Was tut diese Funktion?” — Die KI liest den Code und produziert eine natürlichsprachliche Zusammenfassung. Schneller als den Code selbst zu lesen, aber Sie müssen verifizieren.
- Testgenerierung: “Schreibe Tests für dieses Modul” — Die KI generiert Testfälle, die bestehenden Code ausüben. Schneller als sie von Grund auf zu schreiben, aber Sie müssen bewerten, ob sie sinnvolles Verhalten testen.
- Refactoring-Vorschläge: “Diese Methode ist 45 Zeilen lang. Wie sollte ich sie aufteilen?” — Die KI schlägt Extraktionsmuster vor. Aber Sie müssen sicherstellen, dass das Refactoring das Verhalten bewahrt.
- Dokumentation: “Generiere einen Docstring für diese Funktion basierend auf der tatsächlichen Implementierung” — Die KI erstellt einen Dokumentationsentwurf. Aber Sie müssen prüfen, dass sie beschreibt, was der Code tut, nicht was er tun könnte.
- Code-Navigation: “Verfolge, wie Antwortzeitdaten vom HTTP-Handler zum HTML-Report fließen” — Die KI folgt dem Codepfad über Dateien hinweg. Aber Sie müssen jeden Schritt verifizieren.
Wo KI im Brownfield Schwierigkeiten hat:
- Architekturentscheidungen: Die KI versteht nicht, warum die Architektur so ist, wie sie ist. Sie kann Änderungen vorschlagen, die lokal sinnvoll sind, aber breitere Designprinzipien verletzen.
- Ungeschriebene Konventionen: Wenn das Projekt ein implizites Muster hat, das nicht dokumentiert ist, wird die KI es nicht befolgen.
- Seiteneffekte und Zustand: Die KI kann übersehen, dass eine Funktion gemeinsamen Zustand mutiert, einen Cache invalidiert oder ein Event auslöst — besonders gefährlich in nebenläufigem Code.
- Legacy-Muster: Mancher Code existiert aus historischen Gründen (Rückwärtskompatibilität, Workarounds für alte Bugs). Die KI kann “Verbesserungen” vorschlagen, die Dinge kaputt machen.
- Scope-Kontrolle: Die KI neigt dazu, größere Änderungen als nötig vorzuschlagen. Im Brownfield ist die sicherste Änderung die kleinste, die das Ziel erreicht.
Beachten Sie, was diese fünf Schwächen gemeinsam haben: Es handelt sich um Dinge, zu denen sich das Projekt verpflichtet hat. Die Architektur wurde bewusst gewählt. Die Konventionen haben sich aus guten Gründen entwickelt. Die Legacy-Muster existieren, weil ihre Entfernung reale Nutzer:innen beeinträchtigen würde. Das sind keine willkürlichen Einschränkungen — es sind die akkumulierten Entscheidungen, die die Identität des Projekts definieren. Sie leben in der Teamkultur, in Code-Review-Normen, im institutionellen Gedächtnis langjähriger Entwickler:innen.
Hier schließen Projektanweisungsdateien den Kreis. Sobald eine festgelegte Entscheidung explizit gemacht wird — in eine CLAUDE.md geschrieben, in einer Definition-of-Done-Checkliste kodiert, in einem Architecture Decision Record dokumentiert — wird die KI deutlich besser darin, ihr zu folgen. “Verwende immer die bestehende StatsEntry-Klasse, erstelle nie eine parallele Stats-Struktur” ist genau die Art von Regel, der eine KI über Hunderte generierter Zeilen folgen kann, ohne müde zu werden oder es zu vergessen. Aber “besser” ist nicht “perfekt”. Komplexe Generierungsaufgaben können Stil- und Konventionsanweisungen verdrängen — die KI konzentriert sich darauf, korrekte Logik zu produzieren, und vergisst die Linting-Regeln. Deshalb funktionieren explizite Anweisungen und automatisierte Durchsetzung (Linter, Pre-commit-Hooks, CI-Checks) am besten als zwei komplementäre Schichten: Die CLAUDE.md beeinflusst das KI-Verhalten, und die Tooling-Ebene fängt auf, was durchrutscht. Die oben aufgeführten Schwächen sind keine permanenten KI-Schwächen. Sie sind Symptome von implizitem Wissen, das noch nicht explizit gemacht wurde — und selbst wenn es explizit gemacht wird, profitiert es immer noch von automatisierter Durchsetzung.
Es gibt eine separate, fortgeschrittenere Frage: Was, wenn das Team eine festgelegte Entscheidung überdenken möchte? “Sollten wir dieses Legacy-Muster wirklich beibehalten, oder ist es Zeit für eine Migration?” Das ist ein strategisches Gespräch, keine Coding-Aufgabe — und KI kann dazu als Diskussionspartner beitragen, indem sie Trade-offs aufzeigt und Alternativen erkundet. Aber dieser Anwendungsfall unterscheidet sich grundlegend vom täglichen Brownfield-Coding, und wir werden ihm später im Kurs begegnen, wenn wir KI-gestützte Architekturüberprüfung besprechen.
Die ausgewogene Botschaft bleibt: KI ist Ihr bester Lesepartner in einer Codebasis, die Sie nicht geschrieben haben. Sie kann schneller erklären, vorschlagen, Tests generieren und Dokumentation entwerfen als Sie allein. Aber sie kann Ihr Urteilsvermögen nicht ersetzen — darüber, was sicher geändert werden kann, welche Konventionen zu befolgen sind und ob die Erklärung tatsächlich korrekt ist. Sie sind das Sicherheitsnetz. Die KI ist der Beschleuniger. Und je mehr der festgelegten Entscheidungen Ihres Projekts Sie explizit machen — in Anweisungsdateien, in Checklisten, in Dokumentation — desto effektiver kann die KI innerhalb dieser Grenzen arbeiten.
4. Einstieg in das Locust-Ökosystem
4.1 Was ist Locust?
Heute werden Sie in einem realen Open-Source-Projekt arbeiten: Locust. Locust ist ein Python-Lasttest-Framework mit etwa 25.000 Sternen auf GitHub. Sie schreiben Benutzerverhaltensskripte in Python, und Locust simuliert Tausende gleichzeitiger Benutzer, die auf Ihr System zugreifen — und misst dabei Antwortzeiten, Fehlerraten und Durchsatz.
Um Open-Source-Beiträge ohne Risiko zu simulieren, haben wir das Locust-Repository in unsere Kursorganisation importiert: hs-aalen-software-engineering/locust. Dies ist eine vollständige Kopie — kein Fork — mit der kompletten Commit-Historie (6.000+ Commits, 200+ Tags, alle Branches). Es hat keine Verbindung zum Upstream-Repository: Nichts, was Sie pushen, wird das echte Locust-Projekt beeinflussen, und keine Upstream-Änderungen werden in Ihrer Kopie erscheinen. GitHub Actions sind deaktiviert, um unser Kontingent zu schonen — Sie führen Tests stattdessen lokal aus. Branch Protection auf master erfordert ein genehmigendes Review vor dem Merge, genau wie in einem echten Open-Source-Projekt. Sie werden Branches erstellen, Pull Requests öffnen und die Arbeit der anderen reviewen — derselbe Workflow, den echte Contributors nutzen.
Warum Locust? Mehrere Gründe:
Performance IST das Produkt. Anders als bei einer typischen Webanwendung, wo Performance eine nicht-funktionale Anforderung ist, besteht der gesamte Zweck von Locust im Messen und Erzeugen von Last. Wenn Sie Code in Locust ändern, ist die Frage “Hat meine Änderung es langsamer gemacht?” nicht akademisch — sie betrifft direkt das Kernwertversprechen des Tools. Das macht “Erfolg messen” zu einem natürlichen Teil der Übungen, nicht zu einem künstlichen Zusatz.
Passend dimensionierte Codebasis. Der Kern von Locust umfasst ungefähr 10.000 Zeilen Python, organisiert in klare Module. Er ist groß genug, dass Sie nicht alles in einer Sitzung lesen können, aber klein genug, dass Sie ein einzelnes Modul innerhalb einer Vorlesungssitzung verstehen können.
Es verwendet pytest. Sie kennen pytest bereits aus Ihren Software-Engineering-Voraussetzungen. Die Testsuite von Locust verwendet unittest.TestCase-Basisklassen mit pytest als Runner — ein gängiges Muster in ausgereiften Python-Projekten. Sie müssen kein neues Test-Framework lernen.
Es ist aktiv. Locust wird aktiv weiterentwickelt mit regelmäßigen Releases. Sie arbeiten an etwas Echtem, nicht an einem verlassenen Lehrbeispiel.
4.2 Die Locust-Codebasis im Überblick
Wenn Sie das Repository klonen und in Ihrem Editor öffnen, sehen Sie eine Struktur wie diese (vereinfacht):
locust/
├── locust/                     # Core Python package
│   ├── __init__.py             # Public API + gevent monkey-patching
│   ├── main.py                 # CLI entry point
│   ├── env.py                  # Environment — central orchestration object
│   ├── runners.py              # LocalRunner, MasterRunner, WorkerRunner
│   ├── stats.py                # Request statistics and percentile calculation
│   ├── web.py                  # Flask web UI + REST API
│   ├── event.py                # EventHook pub/sub system
│   ├── clients.py              # HttpSession (requests wrapper with stats)
│   ├── user/                   # User model and task system
│   │   ├── users.py            # User, HttpUser base classes
│   │   └── task.py             # @task, @tag decorators, TaskSet
│   ├── contrib/                # Protocol-specific clients (mqtt, postgres, ...)
│   ├── rpc/                    # ZeroMQ master↔worker communication
│   ├── webui/                  # React + TypeScript frontend
│   └── test/                   # Test suite (~700 test methods)
├── docs/                       # Sphinx documentation
├── examples/                   # 40+ example locustfiles
├── pyproject.toml              # Project configuration
├── .github/
│   └── copilot-instructions.md # AI context for GitHub Copilot
├── CLAUDE.md                   # AI context for Claude Code (615 lines)
└── README.md
Die Module, mit denen Sie am meisten arbeiten werden:
stats.py— Die Statistik-Engine. Sammelt Antwortzeiten, berechnet Perzentile (Median, p95, p99), aggregiert Daten über Anfragen hinweg. Hier leben die Performance-Metriken.runners.py— Orchestriert die Lasttest-Ausführung. Verwaltet das Spawnen und Stoppen simulierter Benutzer, verteilt Last im Master/Worker-Modus.web.py— Die Weboberfläche und REST-API. Stellt das Dashboard bereit, in dem Sie einen laufenden Lasttest überwachen, und bietet Endpunkte für Statistikdaten.user/users.py— Die Basisklassen, die Benutzer ableiten, um ihre Testskripte zu definieren. Definiert, wie simulierte Benutzer warten, Aufgaben wählen und Antworten verarbeiten. Der@task-Dekorator und dasTaskSet-System befinden sich inuser/task.py.
Beachten Sie, dass Tests innerhalb des locust/-Pakets unter locust/test/ liegen, nicht in einem separaten tests/-Verzeichnis auf der obersten Ebene. Das unterscheidet sich vom typischen Python-Projektlayout — eine von vielen Konventionen, die Sie beim Erkunden einer neuen Codebasis entdecken werden.
Sie müssen heute nicht all das verstehen. In den Übungen konzentrieren Sie sich auf jeweils ein Modul — genau wie Sie es tun würden, wenn Sie als neues Teammitglied in ein reales Projekt einsteigen.
4.3 Die Testsuite ausführen
Voraussetzungen zur Auffrischung: Der Rest dieser Vorlesung setzt Vertrautheit mit Git-Grundlagen (Commits, Branches, Staging Area), Feature-Branch-Workflows und Pull Requests voraus. Falls Sie eine Auffrischung benötigen, lesen Sie die Vorlesung Feature Branch Development aus dem Software-Engineering-Kurs. Die Schlüsselkonzepte, die Sie heute brauchen: Feature Branches (feature/<description>), Pull Requests mit Reviews und lokales Testen vor dem Pushen.
Das Erste, was Sie in jedem bestehenden Projekt tun — bevor Sie Code lesen, bevor Sie die KI irgendetwas fragen — ist die Tests ausführen. Das etabliert Ihre Baseline: Alles besteht, die Codebasis ist in einem bekannt guten Zustand, und jeder zukünftige Testfehler wurde durch etwas verursacht, das Sie getan haben.
# Clone from the course organization (not the original repo)
git clone https://github.com/hs-aalen-software-engineering/locust.git
cd locust

# Install dependencies (Locust uses uv)
uv sync

# Run the full test suite
pytest locust/test/

# Run with coverage report
pytest --cov=locust --cov-report=term-missing locust/test/
Wenn Sie pytest --cov ausführen, sehen Sie einen Coverage-Report, der zeigt, welche Module hohe Abdeckung haben und wo Lücken bestehen. Diese Lücken sind real — sie stehen für Codepfade, die kein Test ausübt. Einige dieser Lücken sind genau dort, wo Sie in den Übungen neue Tests schreiben werden.
Denken Sie daran: Es gibt kein CI in diesem Lehr-Repository — GitHub Actions sind deaktiviert. Sie sind das CI. Führen Sie Tests vor jedem Push aus.
4.4 Einen Lasttest ausführen
Um zu verstehen, was Locust tut, sollten Sie es auch benutzen. Erstellen Sie ein einfaches Lasttest-Skript, das httpbin.org als Ziel verwendet — einen oeffentlichen Testdienst, der genau fuer diesen Zweck existiert:
httpbin.org is a public service that exists specifically for testing HTTP clients.
# locustfile.py
from locust import HttpUser, task, between

class QuickStartUser(HttpUser):
    wait_time = between(1, 3)
    host = "https://httpbin.org"

    @task
    def hello_world(self):
        self.client.get("/get")

    @task(3)
    def view_items(self):
        self.client.get("/headers")
Starten Sie es:
uv run locust -f locustfile.py
Öffnen Sie http://localhost:8089 in Ihrem Browser. Sie sollten die Locust-Weboberfläche sehen: ein Dashboard, in dem Sie die Anzahl der Benutzer, die Spawn-Rate einstellen und dann Echtzeit-Statistiken beobachten — Anfragen pro Sekunde, Antwortzeiten, Fehlerraten.
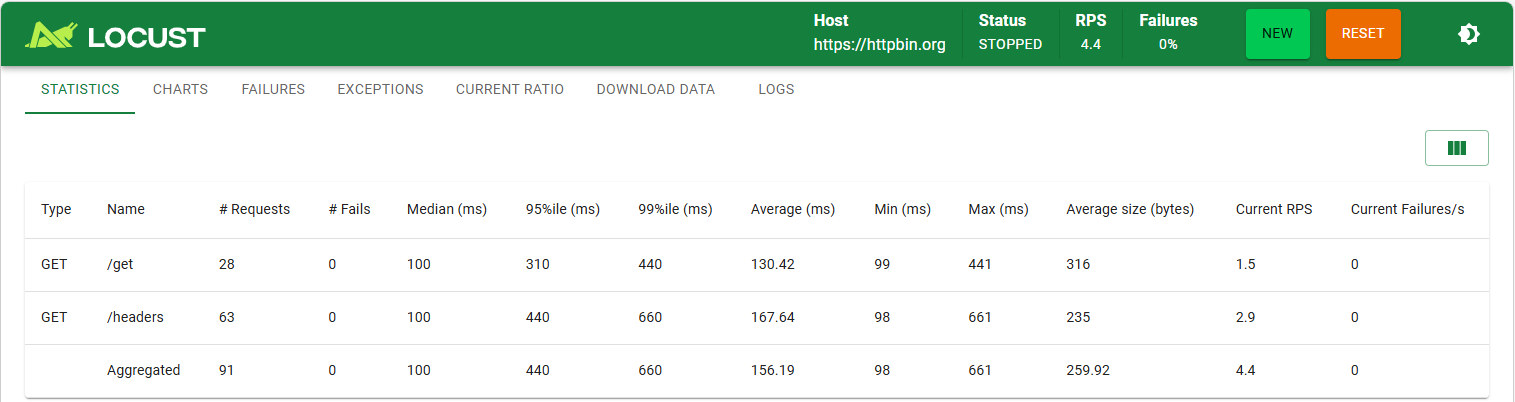
Das ist das Produkt. Das ist es, was der Code, den Sie gleich erkunden werden, tatsächlich tut. Stellen Sie 10 Benutzer ein, Spawn-Rate 2, starten Sie den Test und beobachten Sie die Zahlen. Nutzen Sie Ihr KI-Tool, um die Metriken zu verstehen: Was ist eine gute Antwortzeit? Warum schwankt der RPS-Wert? Was passiert, wenn Sie die Benutzerzahl auf 50 erhöhen?
Hinweis: Falls Sie statt des Dashboards nur eine rohe Textseite sehen, wurde das React-Frontend noch nicht gebaut. Fragen Sie Ihr KI-Tool, wie Sie das beheben können — das ist eine echte Onboarding-Herausforderung. Falls der Frontend-Build auf Ihrem Rechner nicht funktioniert, überspringen Sie diesen Schritt — die Übungen sind reines Python und benötigen die Weboberfläche nicht.
5. CLAUDE.md und Projektkontext
5.1 Das Kontextproblem
Sie haben gerade eine 10.000-Zeilen-Codebasis in Ihrem Editor geöffnet. Sie möchten, dass Ihr KI-Werkzeug Ihnen hilft, sie zu verstehen und zu modifizieren. Aber hier liegt das Problem: Die KI weiß nichts über dieses Projekt.
Sie hat die Verzeichnisstruktur nie gesehen. Sie weiß nicht, dass stats.py die Perzentilberechnung übernimmt. Sie weiß nicht, dass Tests unittest.TestCase-Basisklassen statt pytest-Fixtures verwenden. Sie weiß nicht, dass Tests in locust/test/ liegen, nicht in einem tests/-Verzeichnis auf oberster Ebene. Ohne diesen Kontext wird die KI:
- Vage, generische Antworten geben über “was ein Stats-Modul typischerweise tut”
- Tests generieren, die falsche Import-Pfade verwenden
- Code in einem Stil schreiben, der nicht zur bestehenden Codebasis passt
- Fixtures und Hilfsfunktionen erfinden, die nicht existieren
Sie haben eine Version dieses Problems in Vorlesung 2 erlebt: Jeder Prompt 0 musste das Tagebuchformat spezifizieren, weil sich die KI Konventionen nicht über Sitzungen hinweg merkt. In jenem Fall wiederholten Sie eine 10-zeilige Formatspezifikation. In einer 10.000-Zeilen-Codebasis ist die Dimension des Problems völlig anders — Sie können unmöglich alle relevanten Konventionen in jeden Prompt einfügen.
5.2 Die Lösung: Projektanweisungsdateien
In Vorlesung 2 haben wir CLAUDE.md und .github/copilot-instructions.md als Dateien eingeführt, die das Wiederholungsproblem lösen. Jetzt sehen Sie sie in Aktion — und nicht mit einem Spielbeispiel, sondern mit der echten Datei, die bereits in Ihrem Locust-Repository liegt.
Erinnern Sie sich an die 45-zeilige CLAUDE.md für die Stack Overflow Challenge aus Abschnitt 2.3? Diese Datei war eine Karte eines 250-Zeilen-Projekts, das Sie selbst geschrieben haben. Öffnen Sie jetzt die CLAUDE.md im Locust-Repository. Sie ist über 600 Zeilen lang. Dasselbe Konzept — strukturierter Kontext für einen KI-Assistenten — aber in einer völlig anderen Dimension. Die Stack-Overflow-Version hatte sechs kurze Abschnitte. Die Locust-Version hat ein Inhaltsverzeichnis, Zusammenarbeitsprinzipien, ein Architekturdiagramm, einen “Key Files to Understand First”-Guide, Testdetails, Git-Workflow-Konventionen, häufige Muster, Debugging-Tipps und einen “What NOT to Touch”-Abschnitt. Der Größenunterschied spiegelt den Komplexitätsunterschied wider: Eine Brownfield-CLAUDE.md listet nicht nur Dateien auf — sie kodiert Architektur, Konventionen, Workflows und die Fallen, in die ein Neuankömmling tappen würde.
Hier ist, was passiert, wenn Sie dieselbe Frage, in derselben Codebasis, mit und ohne diese Datei stellen:
Ohne CLAUDE.md — Claude Code zum Stats-Modul befragen:
You: What does the stats module do and how does it track response times?
     Show me the key data structures and their relationships.
Die KI antwortet mit einer generischen Erklärung: “Das Stats-Modul sammelt wahrscheinlich Timing-Daten von HTTP-Anfragen und aggregiert sie zu zusammenfassenden Statistiken. Es verwendet wahrscheinlich irgendeine Form von Dictionary oder Counter, um pro-Endpunkt-Metriken zu verfolgen.” Die Antwort ist plausibel, aber vage. Sie beschreibt, was ein Stats-Modul tun könnte, nicht was dieses Stats-Modul tatsächlich tut. Es werden keine spezifischen Klassen, spezifischen Felder oder spezifischen Datenfluss-Muster erwähnt.
Mit CLAUDE.md — dieselbe Frage:
Die Antwort ändert sich dramatisch. Die KI referenziert StatsEntry und RequestStats namentlich, beschreibt, wie StatsEntry.log() Antwortzeiten aufzeichnet und wie sie sich durch StatsEntry.extend() aggregieren, und verfolgt den Datenfluss vom Event-System bis zur Web-UI. Sie kennt die Modulstruktur, weil die CLAUDE.md ihr gesagt hat, was sie erwarten soll.
Dieselbe KI. Dieselbe Codebasis. Dieselbe Frage. Der einzige Unterschied sind 600 Zeilen strukturierter Kontext.
Das ist die vorbereitete Demonstration für heute. Die Screenshots auf den Folien zeigen die tatsächlichen Vorher-Nachher-Antworten. Nachdem Sie Ihre eigene Projektkopie eingerichtet haben, können Sie dieses Experiment selbst replizieren — und das sollten Sie auch. Den Unterschied im eigenen Editor zu sehen, mit eigenen Fragen, ist überzeugender als jeder Screenshot.
5.3 Anatomie einer guten CLAUDE.md
Anstatt Ihnen ein vereinfachtes Modell zu zeigen, gehen wir die tatsächliche CLAUDE.md in Ihrem Locust-Repository durch. Öffnen Sie sie jetzt — sie liegt im Projektstammverzeichnis. (Wenn Sie GitHub Copilot verwenden, befindet sich die äquivalente Datei unter .github/copilot-instructions.md.) Hier ist ihre Struktur:
| Abschnitt | Was er tut | Warum es wichtig ist |
|---|---|---|
| Collaboration Principles | Weist die KI an, direkt zu sein, vor dem Ändern zu verstehen, vor dem Implementieren zu recherchieren | Das sind Verhaltensanweisungen für die KI — keine Projektdokumentation. Sie formen, wie die KI an Ihre Fragen herangeht. |
| High-Level Overview | Architekturdiagramm, Request-Datenfluss, Runner-Hierarchie, Nebenläufigkeitsmodell | Gibt der KI das mentale Modell, das sie braucht, um Architekturfragen korrekt zu beantworten. |
| Key Directories | Vollständiger Verzeichnisbaum mit einzeiligen Beschreibungen jeder Datei | Verhindert, dass die KI Dateipfade erfindet oder rät, wo Dinge liegen. |
| Key Files to Understand First | Geordnete Liste von 10 Dateien mit Erklärungen, worauf bei jeder zu achten ist | Der Brownfield-Onboarding-Guide. Ihre 45-zeilige SO-Challenge-Version brauchte das nicht — vier Dateien brauchen keine Lesereihenfolge. Zehntausend Zeilen Code schon. |
| Commands | Exakte Befehle zum Testen, Linten, Erstellen des Frontends | Damit die KI die richtigen Befehle vorschlägt, nicht generische. |
| Testing Details | Testorganisation, Basisklassen, Hilfsfunktionen, Testprinzipien | Locust verwendet unittest.TestCase-Basisklassen, nicht pytest-Fixtures. Ohne diesen Abschnitt würde die KI pytest-artige Tests generieren, die nicht zum Projekt passen. |
| Git Workflow | Branch-Benennung, Commit-Konventionen, PR-Format | Kodiert den Beitrags-Workflow für dieses Lehr-Repository. |
| Common Patterns | Gevent Greenlets, Metaklassen-basierte Task-Sammlung, Event-basierte Erweiterung, Kontrollfluss über Exceptions | Architekturmuster, die ein Neuankömmling ohne gründliches Lesen nicht entdecken würde. Die KI kann sie jetzt auf Nachfrage erklären. |
| What NOT to Touch | Deaktivierte Workflows, gebaute Frontend-Artefakte, automatisch generierte Versionsdatei | Kontext, den die KI nicht aus dem Code ableiten kann. Die Workflow-Dateien existieren im Repo, aber Actions sind deaktiviert — ohne diesen Hinweis würde die KI sagen "CI wird das abfangen." |
Vergleichen Sie dies mit der CLAUDE.md der Stack Overflow Challenge: sechs Abschnitte, 45 Zeilen, kein Inhaltsverzeichnis, keine Zusammenarbeitsprinzipien, kein Debugging-Guide, kein “What NOT to Touch.” Der Unterschied ist nicht Ausführlichkeit — es ist Komplexität. Ein 250-Zeilen-Projekt, das Sie selbst geschrieben haben, braucht eine Karte in der Größe eines Post-its. Ein 10.000-Zeilen-Projekt, das jemand anderes geschrieben hat, braucht einen Feldführer.
Diese Struktur ist nicht etwas, das wir für diesen Kurs erfunden haben. React (244K Sterne), Deno (106K Sterne), Next.js (138K Sterne) und Dutzende anderer großer Open-Source-Projekte enthalten mittlerweile ähnliche Dateien. Die Locust-CLAUDE.md wurde nach dem Vorbild von Denos CLAUDE.md für ihre Struktur und Foams CLAUDE.md für ihre Zusammenarbeitsphilosophie modelliert — beides echte Produktionsdateien in aktiven Open-Source-Projekten.
Beachten Sie, was nicht in der Datei steht:
- Vollständige Dateiinhalte — die CLAUDE.md ist eine Karte, keine Kopie des Gebiets
- Implementierungsdetails, die sich täglich ändern — keine Zeilennummern, keine internen Variablennamen, nichts, das nach einem Commit veraltet
- Geheimnisse oder Zugangsdaten — committen Sie diese nie in irgendeine Datei eines Repositories
- Subjektive Präferenzen — “verwende beschreibende Variablennamen” ist zu vage. “Tests verwenden
unittest.TestCase-Basisklassen, nicht pytest-Fixtures” ist umsetzbar
5.4 Was CLAUDE.md NICHT garantiert
Folgendes ist bei der Vorbereitung dieses Kurses passiert. Wir haben das Locust-Repository mit einer umfassenden CLAUDE.md eingerichtet — über 600 Zeilen, einschließlich expliziter Anweisungen, hatch run lint:format (den ruff-Linter) vor dem Committen auszuführen und Tagebucheinträge für jede KI-Interaktion zu erstellen. Dann haben wir die KI gebeten, ein Benchmark-Skript zu generieren. Das Ergebnis: Der Benchmark-Code funktionierte korrekt, enthielt aber mehrere PEP-8-Verstöße, die der Linter erkannt hätte. Als wir die KI baten, diese Verstöße zu beheben, tat sie es — aber sie erstellte keinen Tagebucheintrag für diese Folgeinteraktion, obwohl die Tagebuchkonvention in genau der CLAUDE.md beschrieben war, die sie gelesen hatte.
Das ist kein Versagen der CLAUDE.md — es ist eine Einschränkung der Funktionsweise von Projektanweisungsdateien. Die CLAUDE.md ist Einfluss, nicht Durchsetzung. Wenn die KI auf eine komplexe Generierungsaufgabe fokussiert ist (ein Benchmark-Skript mit mehreren Funktionen, Fixtures und Ausgabeformatierung schreiben), kann das Ziel “korrekten Code produzieren” die Ziele “Lint-Regeln befolgen” und “Tagebucheinträge erstellen” überwiegen. Die Anweisungen stehen noch im Kontext, aber sie konkurrieren um die Aufmerksamkeit des Modells mit dem unmittelbaren Coding-Problem.
Die praktische Lektion: CLAUDE.md und automatisierte Tooling-Ebenen sind komplementäre Schichten, keine Alternativen.
- CLAUDE.md lehrt die KI, worauf sie abzielen soll — Konventionen, Muster, Workflow-Erwartungen. Sie macht die KI deutlich besser. Aber sie ist probabilistisch, nicht deterministisch.
- Pre-commit-Hooks fangen Verstöße bevor sie ins Repository gelangen. Sie laufen automatisch bei jedem
git commit— keine menschliche Disziplin erforderlich. Das Locust-Repo hat das bereits: Öffnen Sie.pre-commit-config.yamlund Sie sehen ruff als Pre-commit-Hook konfiguriert. Jeder Commit führt automatischruff check --fix(den Linter) undruff-format(den Formatierer) aus. Wenn Ihr Code PEP-8-Verstöße hat, wird der Commit abgelehnt. Das ist die Durchsetzungsschicht, die die Einflussschicht der CLAUDE.md zuverlässig macht. - CI-Pipelines (GitHub Actions, Jenkins usw.) sind die Absicherung — sie führen die vollständige Testsuite, Coverage-Checks und Linting bei jedem Push oder PR aus. In einem professionellen Projekt wird nichts ohne bestandenes CI gemergt. In unserem Lehr-Repo ist CI deaktiviert, um das Kontingent zu schonen — was bedeutet, dass die Pre-commit-Hooks Ihr primäres Sicherheitsnetz sind.
- Ihre eigene Disziplin — prüfen “Habe ich einen Tagebucheintrag erstellt?” — bleibt die letzte Schicht für Dinge, die Automatisierung nicht durchsetzen kann. Sie sind der Mensch in der Schleife.
Um die Pre-commit-Hooks in Ihrem lokalen Klon zu aktivieren:
pip install pre-commit
pre-commit install
Danach führt jeder git commit automatisch ruff aus. Sie können es auch jederzeit manuell ausführen — entweder über die Kommandozeile (uv run ruff check . && uv run ruff format --check) oder über die ruff-Extension in VS Code, die Verstöße in Echtzeit beim Tippen hervorhebt.
In einem professionellen Projekt arbeiten all diese Schichten zusammen: CLAUDE.md leitet die KI, Pre-commit-Hooks fangen lokale Fehler, CI fängt alles auf, was durchrutscht, und Code Review liefert menschliches Urteilsvermögen. Auch im Zeitalter KI-gestützten Codings bleiben diese automatisierten Prüfungen unverzichtbar — wohl sogar unverzichtbarer, weil die KI schneller Code generiert, als ein Mensch jede Zeile manuell auf Stil-Konformität prüfen kann.
Warum ignoriert die KI manchmal Anweisungen, die sie eindeutig erhalten hat? Die mechanistische Antwort lernen Sie in Akt II, wenn wir untersuchen, wie Attention funktioniert und warum Kontextanweisungen probabilistisch verarbeitet werden, nicht als Regeln. Vorerst ist die Erkenntnis praktisch: Vertrauen, aber überprüfen.
5.5 Die Tool-Äquivalente
Verschiedene KI-Werkzeuge verwenden unterschiedliche Dateinamen für dasselbe Konzept:
| Werkzeug | Anweisungsdatei | Speicherort | Automatisch geladen? |
|---|---|---|---|
| Claude Code | CLAUDE.md |
Projektstammverzeichnis | Ja, bei Sitzungsstart |
| GitHub Copilot | .github/copilot-instructions.md |
.github/-Verzeichnis |
Ja, wenn Copilot das Repo liest |
| Cursor | .cursorrules |
Projektstammverzeichnis | Ja, bei Sitzungsstart |
Das Prinzip ist universell: Kodieren Sie Ihren Projektkontext einmal, in einer Datei, die im Repository lebt, und das KI-Werkzeug liest sie automatisch. Der Dateiname unterscheidet sich zwischen den Werkzeugen, aber Inhalt und Zweck sind identisch.
Das Locust-Repository enthält eine CLAUDE.md. Wenn Sie GitHub Copilot verwenden, kann derselbe Inhalt in .github/copilot-instructions.md platziert werden — Sie haben beide Dateien im Stack Overflow Challenge-Repo nebeneinander gesehen. Der Inhalt ist nahezu identisch; nur der Dateiname und der Speicherort ändern sich.
5.6 Wo das im Kurs einzuordnen ist
In Vorlesung 2 haben Sie von Projektanweisungsdateien gehört, sie aber nicht verwendet. Heute erhalten Sie eine vorkonfigurierte CLAUDE.md und erleben ihre Wirkung aus erster Hand. Sie müssen noch keine selbst schreiben — das kommt in Akt III, wenn wir dieses Thema mit tieferem Verständnis wieder aufgreifen.
Diese spezielle CLAUDE.md wurde nicht beiläufig geschrieben. Sie wurde durch das Studium der Anweisungsdateien großer Open-Source-Projekte entworfen — Projekte wie Deno (106K Sterne) für ihre progressive Struktur und Foam (16K Sterne) für ihre Zusammenarbeitsphilosophie. In Akt III werden Sie bewerten, ob diese CLAUDE.md tatsächlich gut ist, was fehlt und was Sie ändern würden — sobald Sie verstehen, wie diese Dateien auf Token-Ebene funktionieren. Vorerst: Nutzen Sie sie einfach und bemerken Sie den Unterschied, den sie macht.
Beachten Sie aber die Progression: Das strukturierte Denken, das Sie in Ansatz 3 geübt haben — Konventionen definieren, Formate spezifizieren, Prozesse kodieren — ist genau das, was in eine CLAUDE.md einfließt. Sie lernen diese Fähigkeit bereits. Heute sehen Sie das Tooling, das ihre Bereitstellung automatisiert.
6. Erfolg in bestehenden Codebasen messen
In der Stack Overflow Challenge bedeutete Erfolg: “Der Plot sieht richtig aus.” Das war eine angemessene Messlatte für eine in sich geschlossene Übung. In einem bestehenden Projekt liegt die Messlatte höher — und ist präziser definiert.
6.1 Tests bestehen
Die bestehende Testsuite ist Ihr Vertrag mit der Codebasis. Nach jeder Änderung, die Sie vornehmen, müssen die relevanten Tests weiterhin bestehen.
In der Praxis führen Sie nicht nach jeder Änderung die gesamte Testsuite aus — in einem großen Projekt kann das Minuten oder sogar Stunden dauern. Stattdessen führen Sie die Tests für die Module aus, die Sie berührt haben:
# Run only the tests relevant to your change (~8-22 seconds)
uv run pytest locust/test/test_stats.py -x -q

# Before pushing: run a broader subset to catch cross-module regressions
uv run pytest locust/test/test_stats.py locust/test/test_env.py \
  locust/test/test_locust_class.py -x -q
Das -x-Flag stoppt beim ersten Fehler — schnelles Feedback beim Iterieren. Das -q-Flag reduziert die Ausgabe. Ihr Übungspaket enthält den exakten Testbefehl für Ihre Module.
Wenn ein Test nach Ihrer Änderung fehlschlägt, haben Sie ein Versprechen gebrochen. Entweder ist Ihre Änderung falsch, oder der Test testete absichtlich das alte Verhalten. In beiden Fällen müssen Sie untersuchen, bevor Sie weitermachen. Und denken Sie daran: Es gibt kein CI in diesem Lehr-Repository — Sie sind das CI. Führen Sie Tests vor jedem Push aus.
6.2 Coverage erzählt eine Geschichte
Test-Coverage (pytest --cov) zeigt, welcher Prozentsatz des Codes von der Testsuite ausgeführt wird. Es ist keine perfekte Metrik — 100 % Coverage bedeutet nicht 100 % korrekt — aber sie sagt Ihnen wichtige Dinge:
- Niedrige Coverage in einem Modul bedeutet, dass es Codepfade gibt, die kein Test ausübt. Das sind blinde Flecken, in denen sich Bugs verstecken können.
- Ihr neuer Code sollte Tests haben. Wenn Sie eine Funktion hinzufügen, schreiben Sie Tests dafür. Wenn Sie eine Funktion modifizieren, stellen Sie sicher, dass die bestehenden Tests das modifizierte Verhalten weiterhin abdecken.
- Hohe Coverage mit schwachen Assertions ist schlimmer als niedrige Coverage. Ein Test, der eine Funktion aufruft und
Trueassertiert, deckt Zeilen ab, verifiziert aber nichts. Auf diese Unterscheidung kommen wir in den Übungen zurück.
In einem professionellen Projekt wird Coverage typischerweise automatisch verfolgt: CI generiert einen Coverage-Report mit jedem gemergten PR, und nächtliche Builds erstellen einen vollständigen projektweiten Report. Teams setzen Coverage-Schwellenwerte — wenn ein PR die Coverage unter den Schwellenwert drückt, schlägt der Build fehl. In unserem Lehr-Repo ist CI deaktiviert, also generieren Sie Coverage-Reports lokal. Wir haben die Locust-Codebasis bereits analysiert und spezifische Module mit Coverage-Lücken identifiziert — Ihre Übungspakete enthalten die exakten Funktionen zum Testen und die zu schlagenden Coverage-Prozentsätze.
6.3 Performance: Haben Sie es langsamer gemacht?
In einem Lasttest-Framework ist diese Frage besonders scharf. Wenn Ihre Änderung am Stats-Modul 5 Millisekunden Verarbeitungszeit pro Anfrage hinzufügt und Locust 10.000 Anfragen pro Sekunde verarbeitet, haben Sie gerade 50 Sekunden Overhead pro Sekunde hinzugefügt. Das ist nicht akzeptabel.
Nicht jede Änderung braucht einen formalen Benchmark. Aber Sie sollten sich die Gewohnheit aneignen zu fragen: “Könnte diese Änderung die Performance beeinflussen? Wenn ja, wie würde ich es messen?”
Das Locust-Repository enthält ein Benchmark-Skript, das Operationen pro Sekunde für das Refactoring-Ziel jedes Übungspakets misst. Der Workflow ist einfach: Führen Sie es vor Ihrer Änderung aus, um eine Baseline zu erfassen, refactoren Sie, führen Sie es erneut aus, vergleichen Sie.
# Before your change — capture the baseline
uv run python benchmarks/run_benchmarks.py

# Make your change

# After your change — compare to baseline
uv run python benchmarks/run_benchmarks.py
Die Ausgabe ist nach Übungspaket gruppiert, sodass Sie Ihre Zahlen sofort finden. Was bedeuten die Zahlen? Schwankungen innerhalb von ~10 % sind normales Rauschen (CPU-Last, Hintergrundprozesse). Ein konsistenter Rückgang von 20 % oder mehr bedeutet, dass Ihr Refactoring Overhead eingeführt hat, der untersucht werden sollte — auch wenn die Tests noch bestehen. Nehmen Sie sowohl die Vorher- als auch die Nachher-Zahlen in Ihre PR-Beschreibung auf, damit Reviewer sie überprüfen können. Das Dokument Brownfield Exercises enthält eine Schritt-für-Schritt-Anleitung mit einem konkreten PR-Beispiel.
6.4 Code Review und Pull Requests
Änderungen gelangen durch Pull Requests (PRs) in eine Codebasis. Ein PR ist nicht nur eine Code-Einreichung — er ist ein Kommunikationsartefakt. Die PR-Beschreibung erklärt:
- Was sich geändert hat (der Diff ist direkt da, aber eine menschenlesbare Zusammenfassung hilft)
- Warum es sich geändert hat (Motivation, Issue-Referenz, Benutzeranfrage)
- Wie zu testen (Schritte zur Überprüfung, dass die Änderung wie beabsichtigt funktioniert)
KI kann beim Erstellen von PR-Beschreibungen helfen — und Sie sollten es ausprobieren. Aber wie bei allem anderen müssen Sie überprüfen, dass die Beschreibung korrekt widerspiegelt, was Sie tatsächlich geändert haben. KI-generierte PR-Beschreibungen neigen dazu zu beschreiben, was der Code tun sollte, statt was er tut.
Wenn Sie noch nie mit Pull Requests gearbeitet haben, lesen Sie die Vorlesung Feature Branch Development für den vollständigen PR-Lebenszyklus: Öffnen, Reviewen, Änderungen anfordern und Mergen.
6.5 Das KI-Tagebuch in einer gemeinsamen Codebasis
In Vorlesung 2 haben Sie ein KI-Tagebuch für die Stack Overflow Challenge geführt: eine flache Sequenz nummerierter Einträge in einem diary/-Ordner, einer pro Entwicklungsschritt. Das funktionierte für ein Soloprojekt. In einer gemeinsamen Codebasis mit Dutzenden von Mitwirkenden, die an parallelen Branches arbeiten, würde derselbe Ansatz ein Chaos aus widersprüchlichen Dateinummern und verflochtenen Merge-Historien erzeugen.
Das Locust-Repository verwendet eine Branch-basierte Tagebuchstruktur:
diary/
├── README.md                              # Explains the approach
├── feature/add-retry-logic/               # One subfolder per branch
│   ├── 001-explore-existing-retry.md
│   ├── 002-implement-retry-decorator.md
│   └── 003-add-tests.md
├── fix/stats-percentile-bug/
│   └── 001-investigate-and-fix.md
└── ...
Jeder Eintrag folgt einem Template, das Sie in den Projektanweisungsdateien finden (CLAUDE.md und .github/copilot-instructions.md) — Datum, Werkzeug, Modell, Iterationszahl und der vollständige Prompt-Text. Die zentrale Änderung gegenüber Vorlesung 2: Jeder Tagebucheintrag wird zusammen mit dem Code, den er dokumentiert, committet. Wenn Sie KI nutzen, um einen Test zu generieren, enthält der Commit sowohl die Testdatei als auch den Tagebucheintrag, der sie erzeugt hat. Commit-Messages verwenden das Präfix [diary], damit sie leicht zu filtern sind:
# See all AI-assisted contributions
git log --grep='\[diary\]'
Warum ist das wichtig? Drei Gründe:
Transparenz. In einem Team können Ihre Kolleg:innen nicht nur sehen, was Sie geändert haben, sondern wie Sie dorthin gelangt sind. Ein PR-Reviewer, der Ihre Tagebucheinträge liest, kann beurteilen, ob die KI durchdacht oder blindlings eingesetzt wurde.
Reproduzierbarkeit. Wenn jemand ein Stück KI-generierten Code in sechs Monaten verstehen möchte, zeigt der Tagebucheintrag den exakten Prompt, der ihn erzeugt hat — nicht ein vages “Ich habe die KI gebeten, Tests zu schreiben.”
Lernen. Wenn Sie Ihr eigenes Tagebuch nach einer Sitzung durchgehen, werden Muster erkennbar: welche Prompts funktioniert haben, welche drei Nachfragen brauchten, welche Code produzierten, den Sie komplett umschreiben mussten. Dieses Selbstbewusstsein ist die Fähigkeit, die effektive KI-Nutzer:innen von ineffektiven unterscheidet.
6.6 Die Definition-of-Done-Checkliste
Für jede Übung in dieser Vorlesung bedeutet “fertig”:
- Alle bestehenden Tests bestehen (keine Regressionen) — führen Sie den Testbefehl Ihres Pakets aus
- Neue Tests prüfen tatsächliches Verhalten (nicht nur Zeilenabdeckung)
- Code besteht den Linter — aktivieren Sie Pre-commit-Hooks (
pre-commit install), damit ruff automatisch bei jedem Commit läuft, oder verwenden Sie die ruff-VS-Code-Extension für Echtzeit-Feedback, oder führen Sieuv run ruff check . && uv run ruff format --checkmanuell aus. KI-generierter Code hat häufig Stilverstöße, selbst mit einer CLAUDE.md — Automatisierung fängt auf, was Anweisungen verfehlen. - Refactorter Code bewahrt den Vertrag der ursprünglichen Methode — gleiche Signatur, gleiche Rückgabewerte, gleiche Seiteneffekte
- Performance nicht verschlechtert —
make benchmarkvorher und nachher, Zahlen im PR - Commit-Messages sind klar und aussagekräftig —
[diary]-Präfix für KI-gestützte Commits - KI-Tagebucheinträge dokumentieren den vollständigen Prozess — Prompts, Iterationen, was Sie akzeptiert vs. abgelehnt haben
Diese Checkliste ist auch in der CLAUDE.md und .github/copilot-instructions.md im Locust-Repository kodiert — Ihr KI-Werkzeug liest sie und wird Sie daran erinnern, wenn Sie fragen. Die Übungen verwenden dieselben Kriterien in ihrer Bewertungsmatrix.
7. Die Brownfield-Aufgaben
Sie werden in Teams von 3-5 Studierenden an der Locust-Codebasis arbeiten. Jedes Team bekommt ein spezifisches Übungspaket zugewiesen — eine Zusammenstellung von Modulen, Testzielen und einem Refactoring-Ziel. Sie werden die Testabdeckung verbessern und echten Produktionscode refactoren, wobei Sie KI einsetzen, um die Arbeit zu beschleunigen.
Die Übungen sind in zwei Dokumente aufgeteilt:
- Locust Exploration — Onboarding im Kurs: Setup, Lasttest ausführen, KI als Mentor, Branch erstellen und erster Tagebucheintrag
- Brownfield Exercises — Bewertete Aufgabe: Coverage-Ziele, Refactoring, PR-Liefergegenstände mit Bewertungsmatrix
Der Rest dieses Abschnitts gibt einen Überblick. Die Übungsdokumente enthalten alle Details, Beispiel-Prompts und die Bewertungsmatrix.
Jede Aufgabe nutzt das KI-Tagebuch: Erstellen Sie einen Feature Branch, dokumentieren Sie Ihre Prompts in diary/<branch-name>/ und committen Sie Tagebucheinträge zusammen mit dem Code, den sie erzeugt haben.
7.1 Erste Schritte (Im Kurs, ~20 Minuten)
Sie haben das Repo bereits eingerichtet und einen Lasttest in Abschnitt 4 ausgeführt. Jetzt ist es Zeit, mit der Arbeit zu beginnen. Erstellen Sie zuerst den Feature Branch Ihres Teams und öffnen Sie Ihr KI-Werkzeug. Wenn Sie neu bei Feature Branches und der feature/<description>-Namenskonvention sind, lesen Sie die Vorlesung Feature Branch Development für den vollständigen Workflow.
# Create your team's branch
git checkout -b feature/<team-name>-<task>
# Example: feature/team3-stats-coverage

# Create your diary subfolder
mkdir -p diary/feature/<team-name>-<task>
Öffnen Sie VS Code im Projektverzeichnis. Ihr KI-Werkzeug — ob Claude Code oder GitHub Copilot — liest automatisch die Projektanweisungsdatei (CLAUDE.md oder .github/copilot-instructions.md). Machen Sie einen schnellen Test:
You: What does the stats module do? Show me the key classes.
Wenn die Antwort spezifische Klassennamen referenziert (StatsEntry, RequestStats usw.) statt eine generische Beschreibung zu geben, funktioniert die Anweisungsdatei. Das ist Ihre erste Fähigkeit in der Brownfield-KI-Entwicklung: Die KI bitten, Code zu erklären, den Sie noch nicht gelesen haben, und dann überprüfen, ob die Erklärung korrekt ist. KI ist ein mächtiger Onboarding-Beschleuniger — aber selbst mit einer 600-zeiligen Projektkontextdatei ist Verifikation weiterhin notwendig.
Tagebuch: Ihr erster Eintrag dokumentiert, was Sie die KI über Ihr zugewiesenes Modul gefragt haben und was Sie gelernt haben. Dies ist der Beginn des Tagebuchs Ihres Branches.
7.2 Ihr Übungspaket
Jedes Team bekommt eines von drei Paketen zugewiesen. Die Pakete sind um Module mit schnellen Testsuiten (unter 25 Sekunden) herum konzipiert, damit Sie auf jedem Rechner schnelle Feedback-Schleifen bekommen.
7.2.1 Paket A: Reine Python-Hilfsfunktionen (Am einfachsten)
Modulfokus: locust/util/ + locust/log.py
Testbefehl (~8 Sekunden):
uv run pytest locust/test/test_util.py locust/test/test_log.py \
  locust/test/test_taskratio.py -x -q
Coverage-Ziele — schreiben Sie Tests für:
-
util/cache.py— dermemoize()-Dekorator (derzeit 10 % Coverage). Ein in sich geschlossener, reiner Python-Dekorator ohne externe Abhängigkeiten. Schreiben Sie Tests für: Cache Miss, Cache Hit, Timeout-Ablauf,dynamic_timeout-Verdoppelung undclear_cache(). Ziel: 10 % auf nahe 100 %. -
util/exception_handler.py— derretry()-Dekorator (derzeit 54 % Coverage). Nur der Happy Path ist getestet. Schreiben Sie Tests für: Erfolg beim ersten Versuch, Erfolg beim Retry, Fehlschlag nach allen Versuchen, benutzerdefinierte Exception-Filterung. Ziel: 54 % auf nahe 100 %. -
user/inspectuser.py—_calc_distribution()(derzeit 60 % Coverage). Reine Berechnung mit einfachen User-Klassen-Stubs. Schreiben Sie Tests für: gleiche Gewichte, gemischte Gewichte,fixed_count-User, Randfall null User. Ziel: 60 % auf ~80 %.
Refactoring-Ziel: log.py:setup_logging() (54 Zeilen). Die Funktion baut ein Config-Dictionary auf und fügt bedingt einen File-Handler hinzu. Extrahieren Sie _build_base_config() und _add_file_handler() — drei Funktionen von je ~15 Zeilen statt einer 54-zeiligen Funktion. Bestehende Tests in test_log.py bieten Ihr Sicherheitsnetz.
Geschätzte Zeit: 60-75 Minuten mit KI-Unterstützung.
7.2.2 Paket B: Statistik und Reporting (Mittel)
Modulfokus: locust/stats.py + locust/html.py
Testbefehl (~22 Sekunden):
uv run pytest locust/test/test_stats.py locust/test/test_html_filename.py -x -q
Coverage-Ziele — schreiben Sie Tests für:
-
stats.py—StatsError.parse_error()(Zeilen 715-729). Schreiben Sie Tests für: einfache String-Fehler, Fehler mit Hex-Adressen (die0x....-Ersetzungslogik), Fehler ohne>-Abschluss. Die Hex-Ersetzung ist ein spezifisches, testbares Verhalten. -
stats.py—StatsError.to_name()undStatsError.serialize()(Zeilen 739-766). Schreiben Sie Tests für: String-Fehler,CatchResponseError-Entpackung, Objekt-Fehler. Das sind in sich geschlossene Methoden. -
html.py—get_html_report()(derzeit 34 % Coverage, keine dedizierte Testdatei). Schreiben Sie die ersten Tests für diese Funktion. Sie werdenEnvironmentundRunnermocken müssen, aber die Logik selbst ist eine unkomplizierte Template-Datenzusammenstellung: Zeitbereich, Host-Auflösung, Benutzerzahlen. Das ist eine großartige Gelegenheit, KI-Testgenerierung in Aktion zu sehen — an einem komplett ungetesteten Modul.
Refactoring-Ziel: stats.py:StatsEntry.extend() (43 Zeilen). Diese Methode mergt zwei StatsEntry-Objekte mit vier repetitiven Operationen: Antwortzeiten mergen, Request-Counts mergen, Fehler-Dicts mergen und den Cache aktualisieren. Extrahieren Sie _merge_response_times(), _merge_num_reqs_per_sec() und _maybe_cache_response_times(). Die 62 bestehenden Tests in test_stats.py sind Ihr Sicherheitsnetz.
Geschätzte Zeit: 75-90 Minuten mit KI-Unterstützung.
7.2.3 Paket C: User-Modell und Tasks (Mittel)
Modulfokus: locust/user/ + locust/debug.py
Testbefehl (~9 Sekunden):
uv run pytest locust/test/test_tags.py locust/test/test_locust_class.py \
  locust/test/test_users.py locust/test/test_debugging.py -x -q
Coverage-Ziele — schreiben Sie Tests für:
-
user/task.py—filter_tasks_by_tags()(Zeilen 186-226, derzeit 91 % Coverage). Schreiben Sie Tests für Randfälle, die die bestehende Suite verpasst: leere Tag-Sets, Tasks ohne Tags, überlappende Include- und Exclude-Tags. Ziel: 91 % auf ~95 %. -
user/users.py—HttpUser.__init__()Pool-Manager-Konfiguration (derzeit 81 % Coverage). Schreiben Sie Tests für: benutzerdefiniertepool_manager-Einstellungen, Effekt desconcurrency-Parameters, SSL-Verifizierungsflag. -
debug.py—PrintListener.on_request()(derzeit 45 % Coverage). Schreiben Sie Tests für: erfolgreiche Anfragen, fehlgeschlagene Anfragen mit verschiedenen Exception-Typen,include_time/include_length-Flags. Das ist eine in sich geschlossene Listener-Klasse.
Refactoring-Ziel: user/task.py:filter_tasks_by_tags() (41 Zeilen). Extrahieren Sie _task_matches_tags(task, include_tags, exclude_tags) -> bool als reine Funktion. Die 15 bestehenden Tests in test_tags.py (91 % Coverage) geben Ihnen ein hervorragendes Sicherheitsnetz.
Geschätzte Zeit: 70-85 Minuten mit KI-Unterstützung.
7.3 Die Refactoring-Einschränkungen
Wenn Sie den Refactoring-Teil Ihres Pakets erreichen, gelten diese Regeln:
- Alle bestehenden Tests müssen ohne Modifikation bestehen. Wenn ein Test fehlschlägt, hat Ihr Refactoring das Verhalten geändert — korrigieren Sie das Refactoring, nicht den Test.
- Die öffentliche API darf sich nicht ändern. Gleiche Methodensignatur, gleiche Rückgabewerte, gleiche Seiteneffekte.
- Führen Sie den Performance-Benchmark vorher und nachher aus. Verwenden Sie
make benchmark, um zu bestätigen, dass Ihr Refactoring die Performance nicht verschlechtert hat. Nehmen Sie die Vorher/Nachher-Zahlen in Ihre PR-Beschreibung auf.
KI ist gut darin, Refactoring-Muster vorzuschlagen — Methode extrahieren, umbenennen, umstrukturieren. Aber die semantische Äquivalenz sicherzustellen — dass der refactorte Code genau das tut, was der ursprüngliche tat — erfordert sorgfältiges Nachdenken und das Sicherheitsnetz Ihrer Testsuite. Hier zahlen sich die Coverage-Tests aus, die Sie gerade geschrieben haben: Je gründlicher Sie das ursprüngliche Verhalten getestet haben, desto zuversichtlicher können Sie refactoren.
7.4 Liefergegenstände
Für jedes Team: Reichen Sie einen PR gegen master ein, der enthält:
- Ihre neuen Testdateien mit Coverage-Verbesserungen
- Die refactorte(n) Methode(n) ohne Verhaltensänderungen
- Performance-Benchmark-Zahlen (vorher/nachher) in der PR-Beschreibung
- Tagebucheinträge in
diary/<branch-name>/, die jede KI-Interaktion dokumentieren - Eine PR-Beschreibung, die erklärt, was Sie geändert haben und warum
7.5 Wie die Aufgaben zusammenhängen
Beachten Sie die Progression innerhalb jedes Pakets:
- Erkunden — die KI zu Ihrem zugewiesenen Modul befragen, mit
CLAUDE.mdvergleichen - Testen — Tests für spezifische unabgedeckte Funktionen mit KI-Unterstützung schreiben
- Refactoren — eine lange Methode verbessern, wobei Ihre neuen Tests als Sicherheitsnetz dienen
Das spiegelt wider, wie ein neues Teammitglied sich in eine bestehende Codebasis einarbeitet: zuerst verstehen, dann das Verständnis verifizieren, dann beitragen. Die Tests, die Sie schreiben, sind nicht nur eine Übung — sie werden zur Grundlage, die Ihr Refactoring sicher macht.
8. Kurzreferenz
8.1 Teamzuweisungen
Ihre Lehrperson weist Ihr Team Paket A, B oder C zu. Jedes Paket hat seinen eigenen Modulfokus, Testziele und ein Refactoring-Ziel — siehe Abschnitt 7.2 für alle Details.
8.2 Schnelle Testbefehle
| Paket | Befehl | Laufzeit |
|---|---|---|
| A (Hilfsfunktionen) | uv run pytest locust/test/test_util.py locust/test/test_log.py locust/test/test_taskratio.py -x -q |
~8s |
| B (Statistik) | uv run pytest locust/test/test_stats.py locust/test/test_html_filename.py -x -q |
~22s |
| C (User-Modell) | uv run pytest locust/test/test_tags.py locust/test/test_locust_class.py locust/test/test_users.py -x -q |
~9s |
8.3 Definition of Done
Jeder PR ist vollständig, wenn:
- Alle bestehenden Tests bestehen (keine Regressionen)
- Neue Tests prüfen tatsächliches Verhalten (nicht nur Zeilenabdeckung)
- Refactorter Code bewahrt den Vertrag der ursprünglichen Methode
- Performance nicht verschlechtert (Benchmark-Zahlen im PR)
- Commit-Messages sind klar und aussagekräftig
- KI-Tagebucheinträge dokumentieren den vollständigen Prozess
9. Was Sie heute gelernt haben
Kommen wir auf die Zuversichtsfrage aus dem Feedback-Quiz zu Beginn dieser Sitzung zurück. Sie haben Ihre Zuversicht für das Arbeiten in unbekanntem Code bewertet — wahrscheinlich niedriger als für Greenfield. Nach heute:
- Sie haben eine 10.000-Zeilen-Codebasis geöffnet, ihre Tests ausgeführt, ihre Struktur erkundet und begonnen beizutragen — alles in einer einzigen Sitzung.
- Sie haben aus erster Hand erfahren, wie
CLAUDE.mddie Qualität der KI-Unterstützung verändert. Dasselbe Werkzeug, derselbe Code, dramatisch andere Ergebnisse. - Sie haben die fünf zentralen Unterschiede zwischen Greenfield und Brownfield gelernt: Kontext, Tests, Lesen, Definition of Done und Konventionen.
- Sie haben eine konkrete Checkliste für “fertig” in einer professionellen Codebasis: Tests bestehen, Coverage erhalten, Performance bewahrt, PR gereviewed, Tagebuch vollständig.
Die Brownfield-Aufgaben gehen nach heute weiter. Ihr Team sollte die Locust Exploration-Übung abgeschlossen und mit Ihrem zugewiesenen Paket aus den Brownfield Exercises während dieser Sitzung begonnen haben. Die verbleibenden Coverage-Ziele und die Refactoring-Aufgabe sind vor der nächsten Vorlesung fällig. Jeder Schritt baut auf dem vorherigen auf: Die Exploration zwingt Sie zum Lesen, die Tests verifizieren, was Sie gelesen haben, und das Refactoring beweist, dass Sie Code sicher ändern können — wobei KI jeden Schritt beschleunigt.