03 Locust Exploration: Erste Schritte in einer echten Codebasis
March 2026 (1423 Words, 8 Minutes)
Ziel
In dieser Uebung klont ihr ein echtes Open-Source-Python-Projekt — Locust, ein Load-Testing-Framework — und beginnt es mit Hilfe eures KI-Coding-Assistenten zu erkunden. Am Ende werdet ihr:
- Das Projekt lokal eingerichtet und seine Tests ausgefuehrt haben
- Einen Lasttest ausgefuehrt haben, um zu sehen, was die Software tut
- Euer KI-Tool als Onboarding-Mentor genutzt haben, um die Architektur zu verstehen
- Den Feature-Branch eures Teams und den ersten Diary-Eintrag erstellt haben
Dies ist eure erste Begegnung mit Brownfield-Entwicklung — Arbeiten in einer Codebasis, die jemand anderes geschrieben hat.
Teil 1: Klonen und Einrichten
Schritt 1: Kurs-Repository klonen
Wir arbeiten mit einer Lehrkopie von Locust in unserer Kurs-Organisation — nicht dem Original-Repo. Dies ist ein vollstaendiger Import mit der kompletten Commit-Historie, isoliert, damit eure Arbeit das echte Projekt nicht beeinflusst.
git clone https://github.com/hs-aalen-software-engineering/locust.git
cd locust
Schritt 2: Abhaengigkeiten installieren
Locust verwendet uv als Paketmanager:
uv sync
Falls dies fehlschlaegt, kann euer KI-Assistent bei der Fehlersuche helfen. Haeufige Probleme:
uvnicht installiert — siehe docs.astral.sh/uv fuer die Installation- Fehlende Python-Version (Locust erfordert Python 3.10+)
gevent-Build-Fehler unter Windows — erfordert Visual Studio Build Tools mit dem Workload “C++ Build Tools”
Das ist beabsichtigt. Das Projekt einer anderen Person lokal zum Laufen zu bringen ist eine echte Faehigkeit. Nutzt euer KI-Tool, um Setup-Probleme zu loesen — und notiert, was ihr beheben musstet.
Schritt 3: Pre-Commit Hooks aktivieren
Das Locust-Repo enthaelt Pre-Commit Hooks, die automatisch ruff (Linter + Formatter) bei jedem git commit ausfuehren. Aktiviert sie:
pip install pre-commit
pre-commit install
Ab jetzt wird jeder Commit auf PEP-8-Verstoesse geprueft, bevor er ins Repository gelangt. Wenn die Pruefung fehlschlaegt, wird der Commit abgelehnt und die Verstoesse werden angezeigt. Dies ist euer primaeres Qualitaetssicherungsnetz — besonders wichtig, da KI-generierter Code haeufig Stilverletzungen enthaelt, selbst wenn die CLAUDE.md die Konventionen vorgibt.
Ihr koennt auch die ruff-Erweiterung fuer VS Code installieren, um Echtzeit-Feedback beim Tippen zu erhalten.
Schritt 4: Pruefen, dass pytest funktioniert
Fuehrt nicht die gesamte Test-Suite aus — einige Dateien brauchen ueber 2 Minuten und koennen aufgrund von Umgebungsunterschieden fehlschlagen. Waehlt stattdessen eine der folgenden Testdateien aus und fuehrt sie aus, um euer Setup zu ueberpruefen:
uv run pytest locust/test/test_env.py -x -q
uv run pytest locust/test/test_tags.py -x -q
uv run pytest locust/test/test_users.py -x -q
uv run pytest locust/test/test_wait_time.py -x -q
uv run pytest locust/test/test_util.py -x -q
Wenn die Tests bestehen, seid ihr in einem bekannt-guten Zustand. Jeder Fehler ab jetzt wurde durch etwas verursacht, das ihr getan habt.
Hinweis: Tests befinden sich innerhalb des locust/-Pakets unter locust/test/, nicht in einem separaten tests/-Verzeichnis auf oberster Ebene. Dies ist eine von vielen Konventionen, die man beim Erkunden einer neuen Codebasis entdeckt.
Teil 2: Sehen, was die Software tut
Bevor ihr Quellcode lest, benutzt das Produkt. Erstellt ein einfaches Lasttest-Skript, das httpbin.org als Ziel verwendet — einen oeffentlichen Testdienst, der genau fuer diesen Zweck existiert:
httpbin.org is a public service that exists specifically for testing HTTP clients.
# locustfile.py
from locust import HttpUser, task, between

class QuickStartUser(HttpUser):
    wait_time = between(1, 3)
    host = "https://httpbin.org"

    @task
    def hello_world(self):
        self.client.get("/get")

    @task(3)
    def view_items(self):
        self.client.get("/headers")
Fuehrt es aus:
uv run locust -f locustfile.py
Oeffnet http://localhost:8089 in eurem Browser. Ihr solltet die Locust-Weboberflaeche sehen — ein Dashboard, in dem ihr die Anzahl der Benutzer, die Spawn-Rate einstellt und Echtzeit-Statistiken beobachtet:
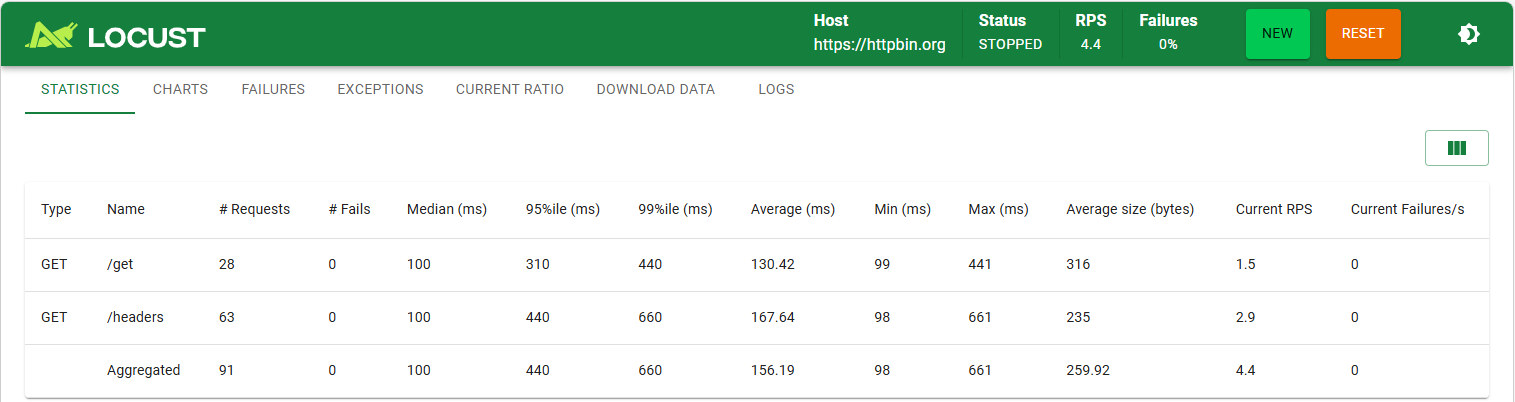
Erkundet das Produkt. Stellt 10 Benutzer ein, Spawn-Rate 2, und startet den Test. Beobachtet, wie das Dashboard sich aktualisiert. Nutzt euer KI-Tool, um zu verstehen, was ihr seht:
- “Was bedeutet ‘Requests per Second’ in diesem Kontext?”
- “Ist eine mediane Antwortzeit von 150ms gut oder schlecht?”
- “Warum schwankt der RPS-Wert?”
- “Was passiert, wenn ich die Benutzerzahl auf 50 erhoehe?”
Hier geht es darum, ein Gefuehl dafuer zu bekommen, was die Software produziert — nicht um den Code dahinter. Ihr seid gerade der Benutzer.
Wenn die Weboberflaeche kaputt aussieht
Wenn ihr statt des oben gezeigten Dashboards eine rohe Textseite oder eine leere Seite seht, wurde das React-Frontend noch nicht gebaut. Die Weboberflaeche ist eine React-Anwendung, die kompiliert werden muss, bevor sie ausgeliefert werden kann.
Dies ist eure erste KI-gestuetzte Debugging-Herausforderung. Fragt euer KI-Tool:
“Ich habe locust gestartet und localhost:8089 geoeffnet, aber ich sehe eine rohe/kaputte Seite statt des Dashboards. Wie behebe ich das?”
Die KI wird euch durch die Installation von Node.js, Yarn und das Bauen des Frontends fuehren. Folgt den Anweisungen.
Falls der Frontend-Build auf eurem Rechner nicht funktioniert (veraltetes OS, fehlende Build-Tools, Unternehmens-Firewall), verbringt nicht mehr als 15 Minuten damit. Das Frontend wird fuer die Test- und Refactoring-Uebungen nicht benoetigt — diese sind reines Python. Springt zu Teil 3 und konzentriert eure Energie dort.
Teil 3: KI als Onboarding-Mentor
Dies ist eine neue Faehigkeit — offensichtlich, aber es lohnt sich, sie explizit zu machen. Oeffnet Claude Code oder GitHub Copilot im Projektverzeichnis. Das KI-Tool liest automatisch CLAUDE.md (oder .github/copilot-instructions.md).
Stellt eurem KI-Tool diese Onboarding-Fragen:
- “Was ist die High-Level-Architektur dieses Projekts?”
- “Wie fliesst eine Benutzeranfrage von der @task-Methode zum Stats-Report?”
- “Was sind die wichtigsten Dateien, die man zuerst lesen sollte?”
Oeffnet nun die CLAUDE.md-Datei und vergleicht die Antworten der KI mit dem, was dort beschrieben wird. Wo fuegt die KI Details ueber die CLAUDE.md hinaus hinzu? Wo liegt sie falsch?
Das lehrt zwei Dinge:
- KI ist ein maechiger Onboarding-Beschleuniger — ihr habt in 5 Minuten mehr ueber diese Codebasis gelernt, als ihr in einer Stunde Lesen geschafft haettet
- Selbst mit einer 600 Zeilen langen Projekt-Kontextdatei ist Verifikation weiterhin notwendig
Teil 4: Branch und Diary erstellen
Feature-Branch eures Teams erstellen
git checkout -b feature/<team-name>-<aufgabe>
# Beispiel: feature/team3-stats-coverage
Diary-Unterordner erstellen
mkdir -p diary/feature/<team-name>-<aufgabe>
Ersten Diary-Eintrag schreiben
Erstellt diary/feature/<team-name>-<aufgabe>/001-onboarding.md mit diesem Template:
# 001 — Onboarding und Exploration

**Date**: YYYY-MM-DD
**Tool**: [Claude Code / GitHub Copilot / ...]
**Model**: [Modellname]
**Iterations**: [Anzahl]

## Prompt

**YYYY-MM-DD HH:MM**

[Die Onboarding-Fragen, die ihr der KI gestellt habt]

## Was ich gelernt habe

- [Wichtige Architektur-Erkenntnisse]
- [Was die KI richtig vs. falsch hatte]
- [Setup-Probleme und wie ihr sie geloest habt]
Committet euren ersten Eintrag:
git add diary/
git commit -m "[diary] 001 — Onboarding and exploration"
Abgaben
- Ein funktionierendes lokales Setup —
uv syncerfolgreich, mindestens eine Testdatei besteht - Der Feature-Branch eures Teams mit erstelltem Diary-Unterordner
- Erster Diary-Eintrag (
001-onboarding.md) mit Dokumentation eurer KI-gestuetzten Exploration
Tipps
- Beginnt mit der CLAUDE.md. Sie ist eure Karte. Lest sie, bevor ihr der KI zufaellige Fragen stellt.
- Wenn ihr beim Setup haengenbleibt, das IST die Uebung. Echte Brownfield-Entwicklung beginnt immer mit “Wie bekomme ich das ueberhaupt zum Laufen?” Nutzt euer KI-Tool, um weiterzukommen.
- Fuehrt nicht
pytest locust/test/(gesamte Suite) aus. Einige Testdateien brauchen 2+ Minuten und haben vorbestehende Fehler aus Umgebungsunterschieden. Waehlt eine der oben aufgelisteten einzelnen Testdateien. - Denkt daran: Ihr seid die CI. GitHub Actions sind in diesem Lehr-Repo deaktiviert. Fuehrt Tests lokal vor jedem Push aus.