01 KI in der Softwareentwicklung: Der Aufstieg KI-gestützter Programmierung
March 2026 (9283 Words, 52 Minutes)
1. Der Montagmorgen, der alles veränderte
Wir schreiben März 2026. Alex, Informatik-Praktikant im 4. Semester bei einem mittelständischen Startup, kommt am Montagmorgen ins Büro. Die Teamleitung nimmt Alex beiseite: “Wir brauchen bis Freitag ein CSV-Analysemodul. Es soll Gesundheitssensordaten parsen, Tagesdurchschnitte berechnen, Anomalien markieren und einen Zusammenfassungsbericht generieren. Schaffst du das?”
Alex hat noch nie etwas Vergleichbares entwickelt. Aber Alex hat GitHub Copilot in VS Code laufen. Eine neue Python-Datei wird geöffnet, ein Docstring mit der Modulbeschreibung getippt – und die KI schlägt Funktion um Funktion vor. Innerhalb von zwei Stunden stehen 200 Zeilen funktionierender Code:
import pandas as pd
from pathlib import Path

def load_sensor_data(filepath: str) -> pd.DataFrame:
    """Load health sensor data from a CSV file and validate columns."""
    df = pd.read_csv(filepath)
    required_cols = ["date", "steps", "heart_rate", "sleep_hours"]
    missing = [c for c in required_cols if c not in df.columns]
    if missing:
        raise ValueError(f"Missing columns: {missing}")
    return df

def flag_anomalies(df: pd.DataFrame) -> pd.DataFrame:
    """Flag rows where heart rate is abnormally high or sleep is very low."""
    df["anomaly"] = (
        (df["heart_rate"] > df["heart_rate"].mean() + 2 * df["heart_rate"].std()) |
        (df["sleep_hours"] < 4.0)
    )
    return df

def generate_summary(df: pd.DataFrame) -> dict:
    """Generate a summary report of health metrics."""
    return {
        "total_days": len(df),
        "avg_steps": df["steps"].mean(),
        "avg_heart_rate": df["heart_rate"].mean(),
        "avg_sleep": df["sleep_hours"].mean(),
        "anomaly_count": df["anomaly"].sum(),
        "date_range": f"{df['date'].min()} to {df['date'].max()}",
    }
Beeindruckend. Der Code sieht sauber aus, verwendet korrekte pandas-Idiome und enthält sogar Docstrings. Alex fühlt sich wie ein 10x-Entwickler. Ein Draft-PR wird gepusht.
Dann beginnen die Probleme.
Problem 1: Die halluzinierte Methode. In einem anderen Teil des Codes schlug Copilot df.rolling_zscore(window=7) vor – eine pandas-Methode, die nicht existiert. Sie sieht plausibel aus. Sie hat sogar den richtigen Parameternamen. Aber zur Laufzeit wirft sie einen AttributeError. Alex verbrachte 20 Minuten damit, den Import zu reparieren, bevor klar wurde, dass die Methode vollständig erfunden war.
Problem 2: Der Test, der nichts testet. Copilot generierte eine Testdatei, die professionell aussieht:
def test_flag_anomalies():
    """Test that anomalies are correctly flagged."""
    df = pd.DataFrame({
        "heart_rate": [70, 72, 68, 71, 69],
        "sleep_hours": [7.5, 8.0, 7.0, 7.5, 8.0],
    })
    result = flag_anomalies(df)
    assert "anomaly" in result.columns  # Only checks the column exists!
Der Test ist grün. Aber er prüft lediglich, ob eine Spalte namens “anomaly” existiert – er verifiziert nicht, ob tatsächlich eine Zeile markiert wurde. Eine Funktion, die blind df["anomaly"] = False setzt, würde diesen Test bestehen. Die KI hat einen Test erzeugt, der ein falsches Sicherheitsgefühl vermittelt.
Problem 3: Der subtile Datumsfehler. Die Funktion generate_summary berechnet den Datumsbereich mit df['date'].min() und df['date'].max(). Aber die Datumsspalte enthält Strings wie "2026-02-28". Stringvergleiche erfolgen lexikographisch, was meistens funktioniert – bis die Daten Einträge wie "2026-1-5" (ohne führende Null) enthalten. Nun wird "2026-1-5" als String verglichen und sortiert nach "2026-12-31", was einen falschen Datumsbereich erzeugt. Alex entdeckt dies erst drei Tage später, als die Testdaten eines Kollegen den Fehler auslösen.
Drei Probleme. Drei verschiedene Fehlermodi. Und alle sahen auf den ersten Blick korrekt aus.
Das ist die Realität der KI-gestützten Softwareentwicklung im Jahr 2026. Die Werkzeuge sind leistungsfähig genug, um Sie dramatisch produktiver zu machen – und subtil genug in ihren Fehlern, um Bugs zu erzeugen, die Sie selbst nie geschrieben hätten. Die Frage ist nicht, ob Sie diese Werkzeuge nutzen sollten. Sie sind bereits da, und sie transformieren die Branche bereits. Die Frage ist: Wie sind wir hierher gekommen? Und wie nutzen Sie diese Werkzeuge, ohne in die Fallen zu tappen, in die Alex getappt ist?
Genau darum geht es in diesem Kurs.
2. Umfang dieser Vorlesung
Was Sie HEUTE lernen werden:
- Der historische Weg von tiefen neuronalen Netzen zur modernen Coding-KI
- Die entscheidenden Durchbrüche, die KI-generierten Code ermöglicht haben
- Die Post-ChatGPT-Zeitlinie und ihre tiefgreifenden Auswirkungen auf die Softwareentwicklung
- Die aktuelle Landschaft der LLM-Anbieter und ihrer Produkte
- Warum dieser Kurs VS Code + GitHub Copilot verwendet
- Was “KI-gestützte Softwareentwicklung” im Jahr 2026 tatsächlich bedeutet
Was Sie (noch) NICHT lernen werden:
- Wie LLMs intern funktionieren – Tokenisierung, Attention, Transformer (Wochen 3-4)
- Prompt-Strategien für bessere Ergebnisse (Woche 5)
- Wie Sie die Qualität von KI-generiertem Code systematisch bewerten (Woche 7)
- Wie Sie KI in professionelle Workflows integrieren (Woche 8)
- Agentische Workflows, in denen KI autonom handelt (Woche 9)
Heute legen wir das historische und kontextuelle Fundament. Alles Weitere baut darauf auf.
3. Die Deep-Learning-Revolution: Ein kurzer historischer Abriss
Um zu verstehen, warum Ihre IDE heute Code schreiben kann, müssen wir einen Schritt zurücktreten. Die KI-Werkzeuge, die Sie heute nutzen, sind nicht aus dem Nichts entstanden. Sie sind das Produkt von über einem Jahrzehnt an Durchbrüchen im Deep Learning – einem Forschungsgebiet, das von den meisten Wissenschaftlern als Sackgasse betrachtet wurde, bis ein einziges Ergebnis im Jahr 2012 alles veränderte.
3.1 Der ImageNet-Moment (2012)
Im Jahr 2012 trat ein Team der University of Toronto – Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton – mit einem tiefen konvolutionalen neuronalen Netz namens AlexNet bei der ImageNet Large Scale Visual Recognition Challenge (ILSVRC) an. ImageNet war der Benchmark, der zählte: 1,2 Millionen Bilder in 1.000 Kategorien klassifizieren. Die besten Ansätze jener Zeit verwendeten handgefertigte Merkmale (SIFT, HOG) in Kombination mit klassischen Klassifikatoren wie SVMs. Die beste bisher erreichte Fehlerrate lag bei 26,2% (Top-5-Fehler).
AlexNet erreichte 15,3%. Keine inkrementelle Verbesserung – ein Rückgang um 10,9 Prozentpunkte. In einem Feld, in dem eine 1%-Verbesserung als bedeutsam galt, war dies ein Erdbeben.
Was AlexNet zum Funktionieren brachte, war nicht ein einzelner Trick, sondern eine Kombination:
- Tiefe Architektur: 8 Schichten (5 konvolutionale + 3 vollverknüpfte), deutlich tiefer als alles, was zuvor funktioniert hatte
- GPU-Training: Das Modell wurde auf zwei NVIDIA GTX 580 GPUs trainiert – eine radikale Idee zu einer Zeit, als die meiste ML-Forschung auf CPUs lief
- ReLU-Aktivierung: Anstelle der traditionellen Sigmoid-Funktion verwendete AlexNet Rectified Linear Units, die deutlich schneller trainierten
- Dropout-Regularisierung: Eine Technik zur Vermeidung von Overfitting durch zufälliges Deaktivieren von Neuronen während des Trainings
Die Auswirkungen waren unmittelbar und unumkehrbar. Innerhalb eines Jahres verwendete praktisch jeder wettbewerbsfähige ImageNet-Beitrag tiefe neuronale Netze. Der “Deep-Learning-Winter” war vorbei. Hinton erhielt zusammen mit Yann LeCun und Yoshua Bengio 2018 den Turing Award für ihre grundlegenden Arbeiten.
Aber warum ist ein Bildklassifikationsergebnis von 2012 für einen Software-Engineering-Kurs im Jahr 2026 relevant? Weil AlexNet ein Prinzip bewies, das schließlich zu GPT-4 und Copilot führen sollte: Bei genügend Daten, genügend Rechenleistung und der richtigen Architektur können neuronale Netze Repräsentationen lernen, die von Menschen entworfene Lösungen übertreffen. Dieses Prinzip – millionenfach skaliert – ist es, das die Code schreibende KI auf Ihrem Bildschirm heute antreibt.
3.2 Die CNN-Ära: Computer Vision wird gelöst (2012-2017)
Nach AlexNet trat die Deep-Learning-Community in eine Phase rasanter architektonischer Innovation ein. Jedes Jahr brachte Netzwerke hervor, die tiefer, effizienter und präziser waren:
| Modell | Jahr | Zentrale Innovation | ImageNet Top-5-Fehler | Parameter |
|---|---|---|---|---|
| AlexNet | 2012 | Tiefe CNNs + GPU-Training | 15,3% | 60M |
| VGGNet | 2014 | Sehr tief (16-19 Schichten), kleine 3x3-Filter | 7,3% | 138M |
| GoogLeNet (Inception) | 2014 | Inception-Module, 22 Schichten, effizient | 6,7% | 6,8M |
| ResNet | 2015 | Residualverbindungen, 152 Schichten | 3,6% | 60M |
| EfficientNet | 2019 | Zusammengesetzte Skalierung (Tiefe + Breite + Auflösung) | 2,9% | 66M |
Parallel zum ImageNet-Wettlauf eroberte Deep Learning weitere Domänen. Generative Adversarial Networks (GANs) (2014) ließen zwei Netzwerke gegeneinander antreten, um realistische Bilder zu erzeugen, und waren Wegbereiter für synthetische Daten. Im Bereich Reinforcement Learning besiegte DeepMinds AlphaGo (2016) den Weltmeister im Go – einem Spiel, das lange als zu komplex für Brute-Force-Suche galt – durch die Kombination tiefer neuronaler Netze mit Monte-Carlo-Baumsuche. Ein Jahr später ging AlphaZero (2017) noch weiter: Ausgehend von nichts als den Spielregeln für Schach, Shogi und Go übertraf es alle bisherigen spezialisierten Engines (einschließlich Stockfish und AlphaGo selbst) durch reines Selbstspiel in weniger als 24 Stunden Training. Diese Ergebnisse bekräftigten, was als “Bitter Lesson” bekannt werden sollte – dass universelles Lernen plus Rechenleistung tendenziell handgefertigtes menschliches Engineering schlägt.
Mehrere Erkenntnisse aus dieser Ära sollten sich als entscheidend für die LLM-Revolution erweisen:
-
Tiefe ist wichtig, aber nicht naiv. VGGNet zeigte, dass einfaches Stapeln weiterer Schichten die Leistung verbessert – bis zu einem gewissen Punkt. Jenseits von ~20 Schichten verschwinden die Gradienten und das Training bricht zusammen. ResNets Residualverbindungen (Skip Connections, die Gradienten über Abkürzungspfade fließen lassen) lösten dieses Problem und ermöglichten Netzwerke mit 152+ Schichten. Diese Erkenntnis – dass architektonische Innovationen Tiefe erschließen – sollte unmittelbar das Transformer-Design beeinflussen.
-
Skalierung erfordert Infrastruktur. Das Training dieser Netzwerke erforderte zunehmend leistungsfähigere GPUs. Der Wechsel von CPU- zu GPU-Computing, den AlexNet eingeleitet hatte, wurde zur Grundlage moderner KI-Infrastruktur. Heutige LLMs werden auf Clustern mit Tausenden von GPUs trainiert, die Hunderte Millionen Dollar kosten.
-
Vortraining auf großen Datensätzen lässt sich übertragen. Modelle, die auf ImageNet trainiert wurden, lernten allgemeine visuelle Merkmale (Kanten, Texturen, Formen), die sich auf andere Aufgaben übertragen ließen (medizinische Bildgebung, Satellitenfotos, autonomes Fahren). Dieses Konzept des Transfer Learning – einmal auf einem riesigen Datensatz trainieren, dann für spezifische Aufgaben feinabstimmen – entspricht genau der Funktionsweise moderner LLMs. GPT-4 wird auf Texten im Internetmaßstab vortrainiert und anschließend für Konversation und Programmierung feinabgestimmt.
Doch CNNs hatten eine fundamentale Einschränkung: Sie waren für räumliche Daten (Bilder) konzipiert. Sprache ist sequenziell. Um von Bilderkennung zu Codegenerierung zu gelangen, benötigte das Feld eine völlig andere Architektur.
3.3 Der Transformer: “Attention Is All You Need” (2017)
Im Juni 2017 veröffentlichte ein Team bei Google ein Paper mit einem der kühnsten Titel der ML-Geschichte: “Attention Is All You Need” (Vaswani et al., 2017). Das Paper führte die Transformer-Architektur ein und veränderte alles.
Vor dem Transformer war der vorherrschende Ansatz für sequenzielle Daten (Text, Sprache, Zeitreihen) das Recurrent Neural Network (RNN) und seine Varianten (LSTMs, GRUs). RNNs verarbeiten Sequenzen Token für Token und pflegen einen Hidden State, der Informationen weiterträgt. Dies hat ein kritisches Problem: Sie sind inhärent sequenziell. Token 50 kann nicht verarbeitet werden, bevor die Token 1 bis 49 verarbeitet wurden. Das macht das Training langsam und erschwert es dem Modell, Informationen aus weit zurückliegenden Sequenzabschnitten zu behalten (das “Vanishing-Gradient-Problem”).
Die zentrale Erkenntnis des Transformers war der Self-Attention-Mechanismus: Anstatt Token sequenziell zu verarbeiten, kann das Modell alle Positionen in der Eingabe gleichzeitig betrachten und lernen, welche Positionen füreinander am relevantesten sind. Bei der Verarbeitung des Wortes “it” in “The function returns None because it encounters an error” kann der Attention-Mechanismus “it” direkt mit “function” verbinden – unabhängig davon, wie viele Token sie trennen.
Wir werden in den Wochen 3-4 im Detail untersuchen, wie Attention funktioniert. Für den Moment zählt die Konsequenz: Transformer können parallel trainiert werden (drastisch schneller) und können Langstreckenabhängigkeiten erfassen (verstehen, wie entfernte Textteile zueinander in Beziehung stehen). Diese Eigenschaften machten es möglich, Sprachmodelle auf Größen zu skalieren, die mit RNNs rechnerisch undenkbar gewesen wären.
Der Transformer war der architektonische Durchbruch, der alles Folgende ermöglichte.
3.4 Von BERT zu GPT-3: Sprachmodelle werden ernst (2018-2020)
Mit der Transformer-Architektur in der Hand entstanden zwei konkurrierende Paradigmen für den Aufbau von Sprachmodellen:
BERT (Bidirectional Encoder Representations from Transformers) – Google, 2018: BERT liest Text in beide Richtungen gleichzeitig. Bei einem Satz mit einem maskierten Wort (“The [MASK] sat on the mat”) berücksichtigt BERT sowohl den linken Kontext (“The”) als auch den rechten Kontext (“sat on the mat”), um “cat” vorherzusagen. Dieses bidirektionale Verständnis macht BERT hervorragend im Verstehen von Text – Klassifikation, Fragebeantwortung, Sentimentanalyse. Aber es kann keinen Text generieren.
GPT (Generative Pre-trained Transformer) – OpenAI, 2018-2020: GPT liest Text ausschließlich von links nach rechts. Bei “The cat sat on the” sagt es das nächste Token vorher: “mat”. Das macht GPT zu einem generativen Modell – es kann neuen Text erzeugen, Token für Token. Der Kompromiss ist, dass es nur den linken Kontext sieht, nicht den rechten. Aber für Codegenerierung ist das tatsächlich in Ordnung: Man schreibt Code von oben nach unten, und die KI erweitert das bisher Geschriebene.
Die GPT-Reihe skalierte rasch:
| Modell | Jahr | Entwickler | Parameter | Zentrale Fähigkeit |
|---|---|---|---|---|
| GPT-1 | 2018 | OpenAI | 117M | Bewies, dass generatives Vortraining funktioniert |
| BERT | 2018 | 340M | Stand der Technik im Sprachverständnis | |
| GPT-2 | 2019 | OpenAI | 1,5B | Kohärente Textgenerierung über mehrere Absätze; "zu gefährlich für die Veröffentlichung" |
| GPT-3 | 2020 | OpenAI | 175B | Few-Shot Learning ohne Fine-Tuning; emergente Fähigkeiten |
| Codex | 2021 | OpenAI | 12B | GPT-3, feinabgestimmt auf Code; trieb den ersten GitHub Copilot an |
Gleichzeitig breitete sich der Transformer weit über Text hinaus aus. Der Vision Transformer (ViT) (2020) zeigte, dass Transformer CNNs bei der Bildklassifikation vollständig ersetzen können – man zerlegt ein Bild einfach in Patches und behandelt sie wie Token. AlphaFold 2 (2020) nutzte eine Transformer-basierte Architektur, um das seit 50 Jahren ungelöste Proteinfaltungsproblem mit nahezu experimenteller Genauigkeit zu lösen, wofür DeepMind einen Nobelpreis erhielt. Und OpenAIs CLIP (2021) lernte, Bilder und Text zu verknüpfen, indem es auf 400 Millionen Bild-Text-Paaren aus dem Web trainiert wurde, was Zero-Shot-Bildverständnis ermöglichte – eine Vision-Sprache-Brücke, die zur Grundlage für DALL·E und spätere Bildgenerierungssysteme wurde. Der Transformer war zur universellen Architektur geworden.
Der Sprung von GPT-2 zu GPT-3 war der Moment, in dem sich für die Softwareentwicklung alles änderte. GPT-3 mit seinen 175 Milliarden Parametern demonstrierte emergente Fähigkeiten – Kompetenzen, die nicht explizit trainiert wurden, sondern als Konsequenz der Skalierung auftraten. Mit wenigen Beispielen (Few-Shot Prompting) konnte GPT-3 Sprachen übersetzen, Aufsätze schreiben, Fragen beantworten und – entscheidend – Code schreiben. Keinen perfekten Code, keinen produktionsreifen Code, aber erkennbaren, funktionalen Code, der als Ausgangspunkt dienen konnte.
OpenAI stimmte GPT-3 auf Milliarden Zeilen öffentlichen Codes von GitHub fein ab und schuf so Codex (2021), das zur Engine hinter der ersten Version von GitHub Copilot wurde. Zum ersten Mal konnte ein Entwickler eine Funktionssignatur eingeben und zusehen, wie eine KI die Implementierung vervollständigte. Die Ära der KI-gestützten Programmierung hatte begonnen.
Die vollständige interaktive Zeitlinie von ImageNet (2012) bis zur modernen Ära finden Sie unter KI-Meilensteine-Zeitlinie.
4. Die Post-ChatGPT-Ära: Als die KI die Softwareentwicklung erreichte
2022 war bereits ein außergewöhnliches Jahr für KI, bevor ChatGPT erschien. Im Januar veröffentlichte OpenAI InstructGPT, das Reinforcement Learning from Human Feedback (RLHF) einführte – eine Technik, die Modelle darauf trainierte, Anweisungen zu befolgen, anstatt nur das nächste Wort vorherzusagen. Dies war die entscheidende Zutat, die ChatGPT konversationell statt roboterhaft wirken lassen sollte. Gleichzeitig war die Bildgenerierungsrevolution in vollem Gange: DALL·E 2 (April), Imagen (Mai) und insbesondere Stable Diffusion (August) – ein Open-Weight-Text-zu-Bild-Modell, das für nur ~600.000 $ trainiert wurde – zeigten, dass generative KI beeindruckende visuelle Inhalte produzieren und für alle zugänglich sein konnte, nicht nur für gut finanzierte Labore.
Dann kam der 30. November 2022. OpenAI veröffentlicht ChatGPT – eine Konversationsoberfläche für GPT-3.5, angetrieben von den RLHF-Techniken aus InstructGPT. Es ist nicht das leistungsfähigste Modell (GPT-4 kommt Monate später). Es ist nicht der erste Chatbot. Aber es ist das erste KI-Produkt, das sich anfühlt, als spreche man mit einem sachkundigen Kollegen. Innerhalb von 5 Tagen 1 Million Nutzer. Innerhalb von 2 Monaten 100 Millionen – die am schnellsten wachsende Verbraucheranwendung der Geschichte.
Für Softwareentwickler war ChatGPT ein Phasenübergang. Plötzlich konnte jeder ein Stück Code in ein Chatfenster einfügen und fragen: “Was macht das?”, “Finde den Bug” oder “Schreibe das in Python um.” Die Hürde für den Einsatz von KI beim Programmieren sank von “Copilot installieren und seine Eigenheiten lernen” auf “einen Browser-Tab öffnen.”
Was folgte, war die intensivste Phase des Wettbewerbs, der Innovation und der Disruption, die die Technologiebranche seit der Smartphone-Revolution erlebt hat.
4.1 2022-2023: Die Grundlagenphase
Das erste Jahr nach ChatGPT etablierte die Akteure, die Muster und das Tempo:
-
November 2022: ChatGPT startet. Basierend auf GPT-3.5 kann es Code schreiben, Konzepte erklären und Fehler debuggen – alles durch natürliche Konversation. Entwickler beginnen sofort, es als “Senior Developer auf Abruf” zu nutzen.
-
Februar 2023: Microsoft integriert GPT in Bing und kündigt eine massive Investition in OpenAI an. Die Botschaft ist klar: KI ist kein Forschungsprojekt mehr, sondern eine Produktstrategie.
-
März 2023: Zwei wegweisende Ereignisse. Erstens: GPT-4 wird veröffentlicht – ein dramatischer Qualitätssprung gegenüber GPT-3.5. Es besteht die Anwaltsprüfung, erzielt Spitzenwerte bei AP-Prüfungen und generiert deutlich besseren Code. Es ist das erste Modell, das sich zuverlässig genug für den professionellen Einsatz anfühlt. Zweitens: Anthropic veröffentlicht Claude und positioniert sich als sicherheitsorientierte Alternative zu GPT-4. Google bringt Bard (später in Gemini umbenannt) eilig auf den Markt. Das KI-Rennen ist offiziell ein Mehrspielerspiel.
-
Juli 2023: Meta veröffentlicht Llama 2 als Open Source (offene Gewichte). Dies ist ein strategisches Erdbeben. Bis dahin waren Frontier-Modelle proprietär – man musste OpenAI oder Google für deren Nutzung bezahlen. Llama 2 erlaubt es jedem, ein wettbewerbsfähiges Sprachmodell herunterzuladen, feinabzustimmen und bereitzustellen. Ein gesamtes Open-Source-Ökosystem beginnt sich darum herum zu bilden.
-
August 2023: Cursor startet – die erste bedeutende KI-native IDE. Anders als GitHub Copilot (das KI als Plugin zu einem bestehenden Editor hinzufügt) ist Cursor von Grund auf mit KI im Kern gebaut: Mehrdatei-Bearbeitungen, Codebase-bewusster Chat und tiefes Kontextverständnis. Dies markiert einen Paradigmenwechsel von “KI als Plugin” zu “IDE, die um KI herum gebaut ist.” Weitere KI-first-Entwicklungsumgebungen folgen rasch.
-
November 2023: GPT-4 Turbo erscheint mit einem Kontextfenster von 128K Token – das Äquivalent eines 300-seitigen Buches. Entwickler können nun ganze Codebases in den Chat einfügen.
4.2 2024: Der Wettbewerb verschärft sich
2024 ist das Jahr, in dem der Wettbewerb schnelle Innovationen bei Modellqualität, Kontextfenstern, Preisgestaltung und Spezialisierung vorantreibt:
-
Februar 2024: Google veröffentlicht Gemini 1.5 Pro mit einem Kontextfenster von 1 Million Token. Das ist kein Tippfehler – eine Million Token, ungefähr 700.000 Wörter oder mehrere vollständige Codebases. Das Kontextfenster-Wettrüsten hat begonnen.
-
März 2024: Anthropic veröffentlicht die Claude 3-Familie und führt einen gestuften Modellansatz ein: Opus (höchste Qualität), Sonnet (ausgewogen) und Haiku (schnell und günstig). Claude 3 Opus erreicht GPT-4-Niveau bei den meisten Benchmarks und übertrifft es bei einigen Programmieraufgaben. Die Ära eines einzelnen “besten Modells” ist vorbei.
-
April 2024: Meta veröffentlicht Llama 3 (8B- und 70B-Parameter-Versionen), und die Open-Source-Community holt weiter auf. Feinabgestimmte Llama-3-Varianten erscheinen innerhalb von Tagen auf Hugging Face, spezialisiert auf Programmierung, medizinisches Schlussfolgern und andere Domänen.
-
Juni 2024: Claude 3.5 Sonnet wird veröffentlicht und führt sofort die SWE-Bench-Rangliste an – den rigorosesten Benchmark für KI-Programmierfähigkeiten, bei dem Modelle echte GitHub-Issues lösen müssen. Dass ein “Mittelklasse”-Modell das Flaggschiff der Konkurrenz übertrifft, sendet eine klare Botschaft: Das Rennen dreht sich um Architektur und Training, nicht nur um Skalierung.
-
Juli 2024: Meta veröffentlicht Llama 3.1 mit einer 405B-Parameter-Version – das erste Open-Weight-Modell, das GPT-4-Klassenleistung erreicht, trainiert für geschätzte ~60 Millionen Dollar. Die Kluft zwischen offenen und proprietären Modellen schrumpft dramatisch.
-
September 2024: Zwei bedeutende Veröffentlichungen. OpenAI stellt o1 vor, das erste “Reasoning-Modell” – es denkt, bevor es antwortet und generiert eine interne Argumentationskette (für den Nutzer nicht sichtbar), bevor es seine Antwort liefert. Dieser Paradigmenwechsel ermöglicht es dem Modell, bei schwierigeren Problemen mehr Rechenleistung einzusetzen. Gleichzeitig veröffentlicht Alibaba Qwen2.5, eine Open-Weight-Familie, bei der das 72B-Modell mit Llama 3.1 405B bei einem Bruchteil der Größe konkurriert, mit einer spezialisierten Qwen2.5-Coder-Variante, die neue Rekorde für Open-Weight-Coding-Modelle aufstellt. Ein drittes großes Open-Weight-Ökosystem entsteht neben Llama und Mistral.
-
Oktober 2024: Anthropic veröffentlicht Claude Computer Use – die erste gängige KI, die einen Computerbildschirm sehen und mit ihm interagieren kann. Anstatt sich über APIs zu verbinden, steuert das Modell Anwendungen visuell: Es klickt, tippt und navigiert wie ein menschlicher Benutzer. Dies eröffnet ein neues Paradigma für KI-Agenten jenseits von Code-Editoren.
-
November 2024: Anthropic führt das Model Context Protocol (MCP) ein – einen offenen Standard, der es KI-Modellen ermöglicht, sich mit externen Datenquellen und Werkzeugen zu verbinden. Anstatt Daten in den Chat einzufügen, kann die KI direkt auf Ihr Dateisystem, Datenbanken, APIs und Entwicklungswerkzeuge über ein standardisiertes Protokoll zugreifen. MCP ist für KI-Werkzeuge das, was USB für Hardware war: ein universeller Anschluss, der proprietäre Integrationen ersetzt.
-
Dezember 2024: Eine Flut von Veröffentlichungen schließt das Jahr ab. Google veröffentlicht Gemini 2.0 mit starken multimodalen Fähigkeiten. OpenAI kündigt o3 an, das 87,5% beim ARC-AGI-Benchmark erreicht – ein großer Sprung im Schlussfolgern. Und DeepSeek-V3 wird aus China veröffentlicht: ein 671B-Parameter-MoE-Modell, das für nur 5,5 Millionen Dollar trainiert wurde und beweist, dass algorithmische Effizienz die Trainingskosten dramatisch senken kann.
4.3 2025-2026: Das Zeitalter der KI-Agenten
Der bedeutsamste Wandel im Jahr 2025 ist kein neues Modell – es ist ein neues Paradigma. KI hört auf, ein Werkzeug zu sein, dem man Fragen stellt, und beginnt, ein Agent zu werden, der eigenständig handelt.
-
Januar 2025: DeepSeek R1 erscheint – ein Open-Source-Reasoning-Modell, das auf der Effizienz von DeepSeek-V3 aufbaut. Es demonstriert, dass Reasoning auf Frontier-Niveau zu einem Bruchteil der Trainingskosten westlicher Modelle erreicht werden kann, und stellt die Annahme infrage, dass nur gut finanzierte amerikanische Unternehmen Frontier-KI entwickeln können.
-
Februar 2025: Drei große Veröffentlichungen in einem einzigen Monat. Anthropic veröffentlicht Claude Code, einen KI-Agenten für die Kommandozeile, der nicht nur Fragen beantwortet – er liest Ihre Dateien, schreibt Code, führt Tests aus, erstellt Commits und öffnet Pull Requests. Claude Code repräsentiert den Wandel von “KI als Chat-Partner” zu “KI als Junior-Entwickler, der in Ihrem Terminal arbeitet.” Gleichzeitig startet GitHub Copilot den Agent Mode in VS Code, der es Copilot ermöglicht, Änderungen über mehrere Dateien hinweg vorzunehmen, Terminal-Befehle auszuführen und Fehler autonom zu iterieren. Und OpenAI veröffentlicht GPT-4.5, mit Fokus auf die Reduktion von Halluzinationen und die Verbesserung des offenen Reasonings.
-
Mai 2025: Anthropic veröffentlicht Claude 4 Sonnet, sein erstes Modell der Claude-4-Generation, das neue Coding-Benchmarks setzt und große Fortschritte bei agentischen Fähigkeiten, der Zuverlässigkeit von Tool-Nutzung und anhaltendem mehrstufigem Reasoning erzielt.
-
Juli 2025: OpenAI veröffentlicht GPT-5 – geschätzt auf über 5 Billionen Parameter (MoE) mit Trainingskosten von 500 Millionen bis 1 Milliarde Dollar. Es verschiebt die Grenzen autonomer agentischer Fähigkeiten und langfristiger Planung und ermöglicht die zuverlässige durchgängige Feature-Implementierung durch KI-Agenten.
-
Oktober 2025: Meta veröffentlicht Llama 4 mit Modellen von bis zu 500 Milliarden Parametern und nativem multimodalem Verständnis, trainiert für geschätzte ~150 Millionen Dollar. State-of-the-Art-Leistung wird frei verfügbar zum Selbst-Hosten.
-
November 2025: DeepSeek-V4 & R2 erscheinen – ein MoE-Modell mit 1,5 Billionen Parametern, trainiert für nur ~12 Millionen Dollar, das GPT-5-Klasse-Leistung erreicht. Der Effizienztrend setzt sich fort: algorithmische Innovation überholt das reine Skalieren von Rechenleistung.
-
Januar 2026: Anthropic veröffentlicht Claude 4.6 (Sonnet und Opus), den aktuellen Stand der Technik für Coding und agentische Workflows. Mit nahezu perfektem Recall über massive Kontextfenster und zuverlässiger Tool-Ausführung wird es zur Standard-Engine für autonomes Software Engineering. Geschätzte Trainingskosten: über 800 Millionen Dollar.
-
Februar 2026: OpenAI veröffentlicht GPT-5.4, stark optimiert für autonome agentische Aufgaben, mit Leistung auf menschlichem Expertenniveau auf SWE-bench. Geschätzte Trainingskosten: über 1,2 Milliarden Dollar.
-
2025-2026: Das MCP-Ökosystem reift heran. KI-Agenten können sich nun mit GitHub verbinden (Issues lesen, PRs erstellen), mit Datenbanken (Daten abfragen), CI/CD-Systemen (Builds auslösen) und Monitoring-Tools (Logs prüfen) – alles über standardisierte Protokolle. Der Workflow verlagert sich von “Kopieren und Einfügen zwischen Browser und IDE” zu “Beschreiben Sie, was Sie wollen, und überprüfen Sie, was die KI gemacht hat.”
Die Entwicklung der Art und Weise, wie Entwickler mit KI interagieren, erzählt die Geschichte deutlich:
graph TD
    A["<b>Chat-basiert</b><br/>(2022-2023)<br/>Code kopieren und<br/>einfügen aus dem Browser"] --> B["<b>IDE-integriert</b><br/>(2023-2024)<br/>Inline-Vervollständigungen<br/>und Chat im Editor"]
    B --> C["<b>Agent Mode</b><br/>(2024-2025)<br/>KI liest Dateien, führt<br/>Befehle aus, erstellt PRs"]
    C --> D["<b>Autonome Workflows</b><br/>(2025+)<br/>KI bearbeitet vollständige<br/>Aufgaben End-to-End mit MCP"]
4.4 Die Auswirkungen: Zahlen, die die Geschichte erzählen
Das Tempo der KI-Entwicklung hat messbare Auswirkungen auf die Softwarebranche hervorgebracht. Einige dieser Zahlen sind beeindruckend. Alle erfordern eine ehrliche Interpretation.
Der StackOverflow-Rückgang
Vielleicht veranschaulicht kein einzelnes Diagramm die Disruption besser als die Traffic-Daten von StackOverflow. Die Plattform, die über ein Jahrzehnt lang die Anlaufstelle für Programmierfragen war, erlebte nach dem Start von ChatGPT einen starken Rückgang:
- Der StackOverflow-Traffic sank zwischen Anfang 2023 und Mitte 2024 um etwa 50%
- Die monatlichen Besuche fielen von rund 1,5 Milliarden auf unter 800 Millionen
- Der Rückgang beschleunigte sich mit jeder neuen Modellveröffentlichung
Warum? Weil es schneller, dialogorientierter und personalisierter ist, ChatGPT eine Programmierfrage zu stellen. Man muss nicht durch fünf Antworten und drei Kommentare suchen, um die Lösung zu finden, die zur eigenen spezifischen Framework-Version passt. Die KI kennt Ihren Kontext (oder gibt es zumindest überzeugend genug vor).
Aber die intellektuelle Redlichkeit, die dieser Kurs verlangt, erfordert Differenzierung: Der StackOverflow-Traffic ging bereits vor ChatGPT zurück, bedingt durch Änderungen in Googles Suchalgorithmus und zunehmende Konkurrenz durch andere Plattformen. ChatGPT hat einen Trend beschleunigt, nicht geschaffen. Außerdem bleiben die Inhalte von StackOverflow wertvoll – ein großer Teil dessen, was LLMs über Programmierung wissen, wurde aus StackOverflow-Antworten in ihren Trainingsdaten gelernt.
GitHub Copilot Adoption
GitHubs eigene Daten erzählen die Geschichte der Adoptionsgeschwindigkeit:
- Über 1,3 Millionen zahlende Abonnenten bis Ende 2024
- 77.000+ Organisationen nutzen Copilot for Business
- GitHub berichtet, dass 46% des neuen Codes auf der Plattform mittlerweile mit Copilot-Unterstützung geschrieben wird
- Ihre Forschung behauptet, Entwickler schließen Aufgaben mit Copilot 55% schneller ab (obwohl diese Zahl eine kritische Betrachtung verdient – wir werden sie in Woche 10 untersuchen)
Stimmung unter Entwicklern
Die Stack Overflow Developer Survey 2024 ergab:
- 76% der Entwickler nutzen KI-Coding-Tools oder planen deren Einsatz
- 70% sagen, KI-Tools verbessern ihre Produktivität
- Aber nur 43% vertrauen der Genauigkeit der KI-Ausgaben
- Die häufigsten Anwendungsfälle: Code schreiben (83%), Debugging (49%), Dokumentation (35%)
Diese Kluft zwischen “verbessert die Produktivität” (70%) und “vertraue der Genauigkeit” (43%) ist die zentrale Spannung dieses gesamten Kurses. Man kann gleichzeitig produktiver und weniger vertrauenswürdig sein, wenn die KI einen schneller darin macht, Code zu produzieren, den man nicht vollständig versteht.
Entlassungen und Umstrukturierungen in der Branche
Zwischen 2023 und 2025 erlebte die Technologiebranche erhebliche Entlassungen – allein 2023 wurden über 260.000 Beschäftigte im Tech-Bereich entlassen, mit fortgesetzten Kürzungen in 2024 und 2025. KI wurde häufig als Faktor genannt, aber intellektuelle Redlichkeit erfordert die Betrachtung des Gesamtbildes:
- Überkorrektur nach der Pandemie (Unternehmen hatten 2020-2021 aggressiv eingestellt)
- Steigende Zinssätze reduzierten Risikokapitalfinanzierung
- Effizienzdruck von Investoren
- KI ermöglicht es kleineren Teams, mehr zu leisten
KI ist ein Faktor unter mehreren. Aber die Erzählung ist relevant: Unternehmen fragen zunehmend “Kann KI diese Rolle ersetzen?”, auch wenn die ehrliche Antwort lautet: “Noch nicht, aber sie kann drei Personen die Arbeit von fünf erledigen lassen.” Für Sie als zukünftige Softwareingenieure bedeutet das: Die Fähigkeit, effektiv mit KI zu arbeiten, ist keine optionale Zusatzqualifikation – sie ist karriereentscheidend.
Trainingskosten und die Frage der Demokratisierung
Die Kosten für das Training von Frontier-Modellen offenbaren sowohl die Konzentration als auch die potenzielle Demokratisierung der KI:
| Modell | Jahr | Geschätzte Trainingskosten | Organisation |
|---|---|---|---|
| GPT-3 | 2020 | ~4,6 Mio. $ | OpenAI |
| DeepSeek-V3 | 2024 | 5,5 Mio. $ | DeepSeek |
| DeepSeek-V4 & R2 | 2025 | ~12 Mio. $ | DeepSeek |
| Llama 2 | 2023 | ~20 Mio. $ | Meta |
| Qwen2.5 | 2024 | ~30 Mio. $ | Alibaba |
| Llama 3.1 405B | 2024 | ~60 Mio. $ | Meta |
| GPT-4 | 2023 | ~100+ Mio. $ | OpenAI |
| Claude 3 | 2024 | ~100+ Mio. $ | Anthropic |
| Llama 4 | 2025 | ~150 Mio. $ | Meta |
| GPT-5 | 2025 | ~500 Mio. - 1 Mrd. $ | OpenAI |
| Claude 4.6 | 2026 | ~800+ Mio. $ | Anthropic |
| GPT-5.4 | 2026 | ~1,2+ Mrd. $ | OpenAI |
Zwei Trends stechen hervor. Erstens ist das obere Ende atemberaubend: Die Trainingskosten sind in nur sechs Jahren von 4,6 Millionen Dollar (GPT-3, 2020) auf über 1 Milliarde Dollar (GPT-5.4, 2026) eskaliert. Zweitens, und überraschender, tauchen immer wieder Effizienz-Ausreißer auf. DeepSeek-V3 erreichte Frontier-Modell-Leistung für 5,5 Millionen Dollar – etwa ein Zwanzigstel der Kosten von GPT-4. DeepSeek-V4 erreichte GPT-5-Klasse für 12 Millionen Dollar. Obwohl exakte Vergleiche kompliziert sind (DeepSeek hat wahrscheinlich von Techniken profitiert, die von teureren Modellen entwickelt wurden), ist der Trend klar: Algorithmische Innovation kann die Kosten dramatisch senken, und mehr Akteure können in das Feld eintreten, als die Schlagzeilen-Trainingsbudgets vermuten lassen.
5. Die LLM-Anbieterlandschaft 2026
Wenn Sie heute als Entwickler versuchen, ein KI-Coding-Tool auszuwählen, stehen Sie vor einer überwältigenden Auswahl an Optionen. Lassen Sie uns die Landschaft kartieren – nicht um einen Gewinner zu küren, sondern um das Terrain zu verstehen.
5.1 OpenAI
Produkte: ChatGPT (Consumer), GPT-4o und GPT-4.5 (multimodal), o1/o3 (Reasoning-Modelle), API-Zugang
Zentrale Stärken: First-Mover-Vorteil, größte Nutzerbasis (über 200 Millionen Nutzer), enge Microsoft-Partnerschaft, das am weitesten integrierte Modell in Drittanbieter-Tools.
Coding-Tools: Betreibt GitHub Copilot (der populärste KI-Coding-Assistent). ChatGPT selbst wird umfassend für Codegenerierung, Debugging und Erklärungen genutzt. Die o-Series Reasoning-Modelle glänzen bei komplexen algorithmischen Herausforderungen.
Geschäftsmodell: Freemium (kostenlose ChatGPT-Stufe) + ChatGPT Plus (20 $/Monat) + API-Abrechnung pro Token + Enterprise-Tarife.
Worin sie am besten sind: Breites allgemeines Coding, großes Ökosystem an Integrationen, Reasoning-Aufgaben (o1/o3).
5.2 Anthropic
Produkte: Claude-Familie (Opus, Sonnet, Haiku – von höchster Qualität bis schnellstem Modell), Claude Code (agentisches CLI-Tool).
Zentrale Stärken: Sicherheitsorientiertes Design (Constitutional AI), starke Coding-Leistung (regelmäßig an der Spitze von SWE-Bench), sehr große Kontextfenster (200K Token Standard), Erfinder von MCP. Claude Code hat das Paradigma “KI-Agent in Ihrem Terminal” begründet.
Coding-Tools: Claude Code (CLI-Agent, der Code liest, schreibt, testet und committet), API für benutzerdefinierte IDE-Integrationen, MCP-Ökosystem für Tool-Konnektivität.
Geschäftsmodell: Claude Pro-Abonnement (20 $/Monat), API-Abrechnung pro Token, Enterprise-Tarife.
Worin sie am besten sind: Komplexe Coding-Aufgaben, die tiefes Verständnis großer Codebasen erfordern, agentische Workflows, sicherheitskritische Anwendungen.
5.3 Google
Produkte: Gemini-Familie (Nano, Flash, Pro, Ultra), Gemma (Open-Source-Kleinmodelle), Gemini Code Assist.
Zentrale Stärken: Massive Infrastruktur (TPU-Cluster), native multimodale Fähigkeiten (Text, Bild, Audio, Video in einem Modell), die größten Kontextfenster (1M+ Token mit Gemini 1.5), tiefe Integration mit Google Cloud.
Coding-Tools: Gemini Code Assist (integriert in Google Cloud und Android Studio), Gemini API für benutzerdefinierte Tooling-Lösungen.
Geschäftsmodell: Google Cloud-Integration, API-Zugang, Consumer (Gemini Chat).
Worin sie am besten sind: Multimodales Verständnis (z.B. einen Screenshot einer Fehlermeldung erklären), Verarbeitung sehr großer Codebasen (1M+ Kontext), Android-/Google Cloud-Entwicklung.
5.4 Meta
Produkte: Llama-Familie (Llama 2, 3, 3.1, 4) – Open-Weight-Modelle, frei zum Download und zur Nutzung.
Zentrale Stärken: Open-Source-Führerschaft. Meta veröffentlicht seine besten Modelle mit offenen Gewichten, sodass jeder sie herunterladen, fine-tunen, hosten und modifizieren kann. Dies hat ein enormes Ökosystem von fine-getunten Varianten hervorgebracht, die für spezifische Aufgaben optimiert sind (Coding, Medizin, Recht).
Coding-Tools: Kein direktes Coding-Produkt. Aber Llama treibt viele Drittanbieter-Tools an: Ollama (lokales Modell-Hosting), Continue (Open-Source-Copilot-Alternative) und Dutzende spezialisierter Coding-Assistenten.
Geschäftsmodell: Kostenlos (Open Source). Metas Strategie besteht darin, KI-Infrastruktur zu kommodifizieren, um zu verhindern, dass OpenAI/Google das Ökosystem kontrollieren, was Metas Kerngeschäft mit Werbung bedrohen würde.
Worin sie am besten sind: Selbst gehostete KI (Datenschutz), benutzerdefiniertes Fine-Tuning, Aufbau KI-gestützter Features ohne API-Kosten.
5.5 DeepSeek
Produkte: DeepSeek V2/V3 (allgemein), DeepSeek Coder (code-spezialisiert), DeepSeek R1 (Reasoning).
Zentrale Stärken: Erreichte Frontier-Leistung bei dramatisch niedrigeren Trainingskosten. DeepSeek R1 demonstrierte, dass Open-Source-Reasoning-Modelle mit o1 zu einem Bruchteil des Preises konkurrieren können. Ihre Effizienzinnovationen (Mixture-of-Experts-Architektur) könnten die Art und Weise verändern, wie Modelle gebaut werden.
Coding-Tools: DeepSeek Coder ist in Coding-Benchmarks wettbewerbsfähig. Verfügbar über API und als Open-Weight-Downloads.
Geschäftsmodell: Open Source + API-Zugang.
Worin sie am besten sind: Kosteneffiziente Coding-Unterstützung, Demonstration, dass Frontier-KI zugänglich sein kann.
Wichtiger Hinweis: DeepSeek operiert von China aus, was Fragen der Datensouveränität und Compliance für europäische Unternehmen aufwirft. Wohin Ihr Code gesendet und wo er gespeichert wird, ist relevant – wir werden dies in Woche 11 im Detail besprechen.
5.6 Weitere wichtige Akteure
Microsoft baut keine eigenen LLMs, ist aber tief in das Ökosystem eingebettet. Azure OpenAI Service bietet Enterprise-Zugang zu GPT-Modellen. Copilot (angetrieben von OpenAI-Modellen) ist das am häufigsten genutzte KI-Coding-Tool. Microsofts Strategie ist es, die Plattformschicht zu sein: Welches Modell Sie auch verwenden, Sie betreiben es auf Azure.
xAI (Grok) ist Elon Musks KI-Unternehmen, integriert in die X-Plattform (ehemals Twitter). Grok hat begrenzte coding-spezifische Tooling-Möglichkeiten, ist aber als weiterer Frontier-Modell-Akteur relevant.
Mistral ist ein französisches KI-Unternehmen, das starke Open-Source-Modelle baut (Mistral 7B, Mixtral 8x7B, Mistral Large). Wichtig für den europäischen Markt wegen der Datensouveränität: Mistral-Modelle können auf europäischer Infrastruktur gehostet werden, DSGVO-konform, ohne Daten an US-amerikanische oder chinesische Server zu senden.
Amazon bietet Bedrock (eine Plattform zum Zugriff auf mehrere Modelle verschiedener Anbieter) und Q Developer (Amazons Coding-Assistent, integriert in AWS). Wichtig für Teams, die bereits im AWS-Ökosystem arbeiten.
So vergleichen sich diese Anbieter:
| Anbieter | Flaggschiff-Modell | Offen / Geschlossen | Am besten für | Max. Kontext | Preismodell | Coding-Tool |
|---|---|---|---|---|---|---|
| OpenAI | GPT-4o / o3 | Geschlossen | Allgemein, Reasoning | 128K | Freemium + API | GitHub Copilot |
| Anthropic | Claude Opus / Sonnet | Geschlossen | Komplexes Coding, Sicherheit | 200K | Abo + API | Claude Code |
| Gemini Ultra / Pro | Geschlossen (Gemma offen) | Multimodal, großer Kontext | 1M+ | Cloud + API | Gemini Code Assist | |
| Meta | Llama 4 | Offene Gewichte | Selbst gehostet, Fine-Tuning | 128K | Kostenlos (selbst gehostet) | (Drittanbieter-Tools) |
| DeepSeek | DeepSeek R1 | Offene Gewichte | Kosteneffizientes Reasoning | 128K | Kostenlos + API | DeepSeek Coder |
| Mistral | Mistral Large | Offen + Geschlossen | Europäische Datensouveränität | 128K | API + selbst gehostet | (Drittanbieter-Tools) |
| Microsoft | (Nutzt OpenAI-Modelle) | Geschlossen | Enterprise, Azure-Ökosystem | 128K | Azure-Preise | GitHub Copilot |
| Amazon | (Multi-Modell via Bedrock) | Gemischt | AWS-Ökosystem | Variiert | AWS-Preise | Q Developer |
5.7 Das Problem der überwältigenden Auswahl
Schauen Sie sich diese Tabelle an. Acht Anbieter, jeder mit mehreren Modellen, unterschiedlichen Preisen, unterschiedlichen Stärken, unterschiedlichen Datenschutz-Implikationen. Und das ist eine vereinfachte Darstellung – es gibt Dutzende mehr, wenn man spezialisierte Fine-Tuning-Varianten, regionale Anbieter und Startup-Angebote mitzählt.
Wie wählt man aus? Wie wählt ein Unternehmen aus? Die Antwort lautet: Sie brauchen eine systematische Methodik zur Evaluation. Sie können nicht einfach das Produkt mit dem besten Marketing oder der höchsten Benchmark-Punktzahl wählen. Sie müssen verstehen:
- Für welche Aufgaben setzen Sie KI ein? (Codegenerierung? Review? Dokumentation? Testen?)
- Welche Datenschutzanforderungen haben Sie? (Darf Code Ihr Netzwerk verlassen? DSGVO-Aspekte?)
- Wie hoch ist Ihr Budget? (API-Kosten skalieren mit der Nutzung – ein Team von 50 Entwicklern kann erhebliche Rechnungen verursachen)
- Wie wichtig ist Reproduzierbarkeit? (Open-Source-Modelle geben Ihnen Kontrolle; proprietäre Modelle können sich ohne Vorankündigung aendern)
- Welche Integrationen benötigen Sie? (Funktioniert das Tool mit Ihrer IDE, Ihrer CI/CD-Pipeline, Ihrem Code-Review-Prozess?)
Diese überwältigende Vielfalt an Anbietern ist genau der Grund, warum dieser Kurs existiert. Ein einzelnes Tool zu erlernen reicht nicht aus. Sie müssen lernen, wie man systematisch evaluiert, vergleicht und auswählt. Diese Fähigkeit werden wir im Laufe des Semesters aufbauen, insbesondere in Woche 7 (Qualitätsevaluation) und Woche 12 (organisatorische Einführung).
Für diesen Kurs müssen wir jedoch ein primäres Tool wählen. Und aus guten Gründen ist dieses Tool GitHub Copilot.
6. Warum VS Code + GitHub Copilot für diesen Kurs
6.1 Die praktische Wahl
Wir haben VS Code + GitHub Copilot aus fünf Gründen als primäres Tool für diesen Kurs gewählt:
1. Kostenlos für Studierende. Über das GitHub Education-Programm erhalten Studierende GitHub Copilot kostenlos. Das beseitigt jede finanzielle Hürde für die Teilnahme. Sie brauchen keine Kreditkarte, kein Abonnement und kein Budget. Sie registrieren sich mit Ihrer Hochschul-E-Mail-Adresse, und Copilot wird aktiviert.
2. Beste IDE-Integration. Copilot wurde für VS Code entwickelt. Die Inline-Vervollständigungen, das Chat-Panel, der Agent-Modus – all das sind native VS-Code-Erfahrungen. Kein Wechseln zwischen Browser-Tabs, kein Kopieren und Einfügen. Die KI ist in Ihrem Editor und versteht Ihren Kontext während Sie tippen.
3. Industriestandard. VS Code ist der weltweit beliebteste Code-Editor (laut Stack Overflow Developer Survey von über 70% der Entwickler genutzt). GitHub Copilot ist das am weitesten verbreitete KI-Coding-Tool. Diesen Stack zu erlernen bedeutet, das zu lernen, was die meisten professionellen Entwicklungsteams bereits einsetzen oder evaluieren.
4. Zunehmend modellunabhängig. GitHub Copilot ist nicht mehr an OpenAI-Modelle gebunden. Seit 2025 unterstuetzt Copilot Claude und Gemini als alternative Backends. Das bedeutet, dass Sie verschiedene Modelle über dieselbe Oberfläche erleben können – wertvoll für Vergleich und Evaluation.
5. Das vollständige Spektrum. Copilot unterstuetzt alle drei Interaktionsmodi, die wir besprochen haben: Inline-Vervollständigungen (die urspruengliche Autocomplete-Erfahrung), Chat (Fragen stellen, Erklärungen erhalten) und Agent-Modus (autonome Bearbeitung über mehrere Dateien). Sie können die gesamte Evolution der KI-Coding-Tools erleben, ohne das Produkt zu wechseln.
6.2 Erste Schritte: Ihre Setup-Checkliste
Hier ist, was Sie für den Einstieg benötigen. Wir werden das gemeinsam in der Übungssitzung durchgehen, aber wenn Sie vorarbeiten möchten:
Schritt 1: GitHub Education
Melden Sie sich für das GitHub Student Developer Pack unter education.github.com an. Sie benötigen Ihre @studmail.htw-aalen.de E-Mail-Adresse. Damit erhalten Sie kostenlosen Zugang zu GitHub Copilot sowie vielen weiteren Entwickler-Tools.
Schritt 2: VS Code installieren
Laden Sie VS Code von code.visualstudio.com herunter. Es ist kostenlos, Open Source und für Windows, macOS und Linux verfügbar.
Schritt 3: GitHub Copilot Extension installieren
Öffnen Sie VS Code, gehen Sie zum Extensions-Panel (Strg+Umschalt+X) und suchen Sie nach “GitHub Copilot”. Installieren Sie beide:
- GitHub Copilot (die Inline-Vervollständigungs-Engine)
- GitHub Copilot Chat (die Chat-Oberfläche)
Schritt 4: Anmelden
Klicken Sie auf das GitHub-Copilot-Symbol in der VS-Code-Statusleiste und melden Sie sich mit Ihrem GitHub-Konto an. Wenn Ihr Education Pack aktiv ist, wird Copilot automatisch aktiviert.
Schritt 5: Funktionalität überprüfen
Erstellen Sie eine neue Python-Datei und beginnen Sie zu tippen. Sie sollten grauen Geistertext sehen, der Vervollständigungen vorschlägt:
# Try typing this in VS Code with Copilot active:
def calculate_average_heart_rate(data: list[dict]) -> float:
    """Calculate the average heart rate from a list of health records."""
    # Copilot should suggest something like:
    # total = sum(record["heart_rate"] for record in data)
    # return total / len(data)
Wenn Sie Vorschläge sehen, während Sie tippen, sind Sie bereit für die Übungen.
Schritt 6: Python Extension installieren
Suchen Sie im Extensions-Panel nach “Python” und installieren Sie die offizielle Microsoft Python Extension. Diese bietet Syntaxhervorhebung, Linting, Debugging und IntelliSense – die Grundlage, auf der Copilot aufbaut.
6.3 Über Copilot hinaus: Was wir außerdem erkunden werden
Obwohl Copilot unser primäres Tool ist, ist dieser Kurs kein Copilot-Tutorial. Im Laufe des Semesters werden Sie auch mit folgenden Werkzeugen arbeiten:
-
Direkter API-Zugang (Woche 6): Sie werden die OpenAI- und Anthropic-APIs direkt aufrufen, um KI-gestützte Funktionen in Ihre Projekte einzubauen. Das vermittelt Ihnen, was hinter der IDE-Integration passiert.
-
Claude Code (Woche 9): Wenn wir agentenbasierte Workflows untersuchen, werden Sie Claude Code verwenden, um zu erleben, wie ein vollständig autonomer KI-Coding-Agent aussieht – und seine Stärken und Grenzen zu verstehen.
-
Mehrere Modelle zum Vergleich (Woche 7): Sie werden dieselbe Programmieraufgabe mit verschiedenen Modellen evaluieren, um eigene Benchmarks aufzubauen und die Evaluationsfähigkeiten zu entwickeln, die diese überwältigende Anbieterlandschaft erfordert.
-
Cursor als alternative IDE: Cursor ist ein VS-Code-Fork mit KI-Fähigkeiten, die direkt in den Editor integriert sind (nicht als Extension). Wir werden es kurz als Beispiel für “KI-natives” IDE-Design betrachten und es dem Ansatz “KI als Plugin” von VS Code + Copilot gegenüberstellen.
6.4 Erste Schritte mit Hugging Face
In diesem Kurs werden wir KI nicht nur über Chat-Fenster und Copilots nutzen – wir werden auch programmatisch auf LLM-Inferenz zugreifen. Das bedeutet, Modelle direkt aus Python-Code aufzurufen, ihre Ausgaben zu inspizieren und sogar Zwischendarstellungen wie Embeddings zu betrachten. Dafür werden wir Hugging Face verwenden, die größte offene Plattform für Machine-Learning-Modelle.
Warum Hugging Face? Hugging Face bietet Ihnen Zugang zu Tausenden von Modellen über eine einheitliche API. Anstatt an einen einzelnen Anbieter gebunden zu sein, können Sie mit verschiedenen Architekturen experimentieren, Ausgaben vergleichen und verstehen, was unter der Haube passiert. Das ist essenziell, um echte Intuition dafür zu entwickeln, wie LLMs funktionieren – nicht nur, was sie produzieren.
Schritt 1: Hugging-Face-Konto erstellen
- Gehen Sie zu https://huggingface.co/ und erstellen Sie ein kostenloses Konto.
- Beanspruchen Sie Ihre Studierendenvorteile unter https://huggingface.co/education. Als Studierende erhalten Sie kostenlosen PRO-Zugang, der höhere Inferenz-Ratenlimits und Zugang zu mehr Modellen umfasst. Sie benötigen eine gültige Hochschul-E-Mail-Adresse.
- Sobald Ihr Konto eingerichtet ist, generieren Sie ein schreibgeschuetztes API-Token unter https://huggingface.co/settings/tokens. Dieses Token benötigen Sie zur Authentifizierung Ihrer API-Aufrufe.
Schritt 2: Starter-Repository klonen und testen
Wir haben ein kleines Starter-Projekt vorbereitet, mit dem Sie verschiedene Hugging-Face-LLMs über die Kommandozeile ausprobieren können. Klonen Sie es und folgen Sie den Setup-Anweisungen:
- Besuchen Sie das Repository: https://github.com/L3GJ0N/hf-llm-uv-starter
- Lesen Sie die
README.mdsorgfältig – sie enthält alle Setup-Schritte. -
Klonen Sie das Repository auf Ihren Rechner:
git clone https://github.com/L3GJ0N/hf-llm-uv-starter.git cd hf-llm-uv-starter -
Erstellen Sie eine
.env-Datei im Projektstammverzeichnis mit Ihrem Hugging-Face-Token:HF_TOKEN=your_token_here -
Probieren Sie die verfügbaren Befehle aus:
# List available models
uv run hf-llm list-models

# Ask a single question
uv run hf-llm ask --model [name] --prompt "What is a Python decorator?"

# Start an interactive chat
uv run hf-llm chat --model [name]
Wenn alles funktioniert, sollten Sie Modellantworten in Ihrem Terminal sehen. Wir werden uns für dieses Setup ausreichend Zeit nehmen – falls Probleme auftreten, melden Sie sich, und wir lösen sie gemeinsam.
7. Die Stack-Overflow-Challenge
7.1 Das Bild
Schauen Sie sich dieses Diagramm an:
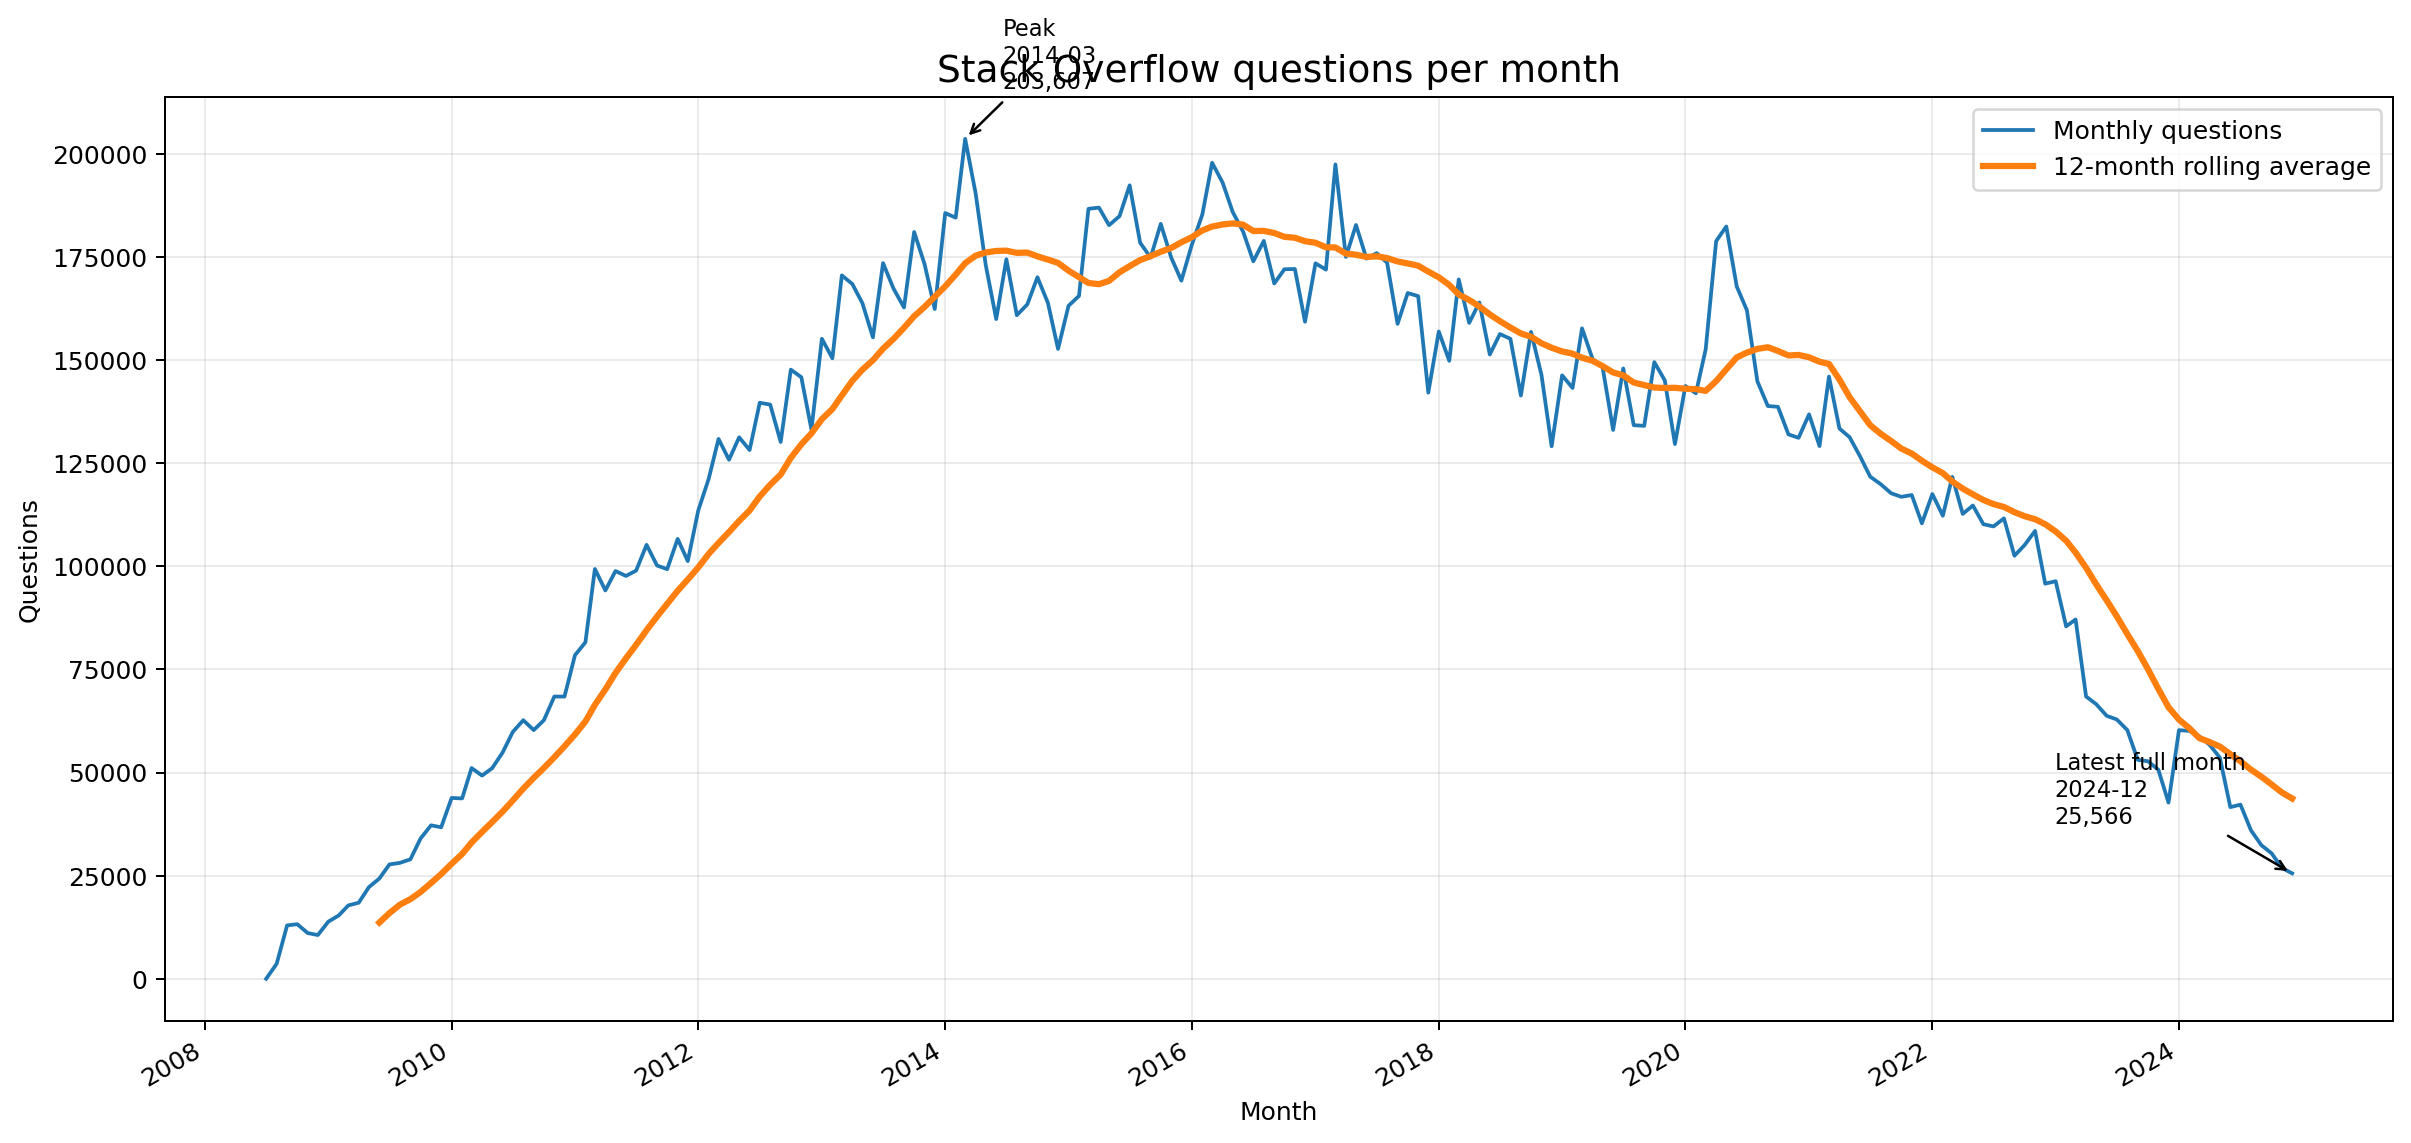
Dies ist die Anzahl der monatlich auf Stack Overflow gestellten Fragen von 2008 bis Ende 2024. Das Muster ist auffällig: ein stetiger Anstieg seit der Gründung von Stack Overflow, mit einem Höchststand um 2014 bei rund 200.000 Fragen pro Monat. Dann ein allmählicher Rückgang – und nach November 2022, als ChatGPT gestartet wurde, ein dramatischer Einbruch. Der jüngste Datenpunkt zeigt etwa 25.000 Fragen pro Monat im Dezember 2024.
Lassen Sie die Daten sprechen. Dies ist eines der sichtbarsten Signale für den Einfluss von KI auf die Softwareentwicklung. Entwickler stellen nicht weniger Fragen – sie stellen sie woanders.
7.2 Die Challenge
Ihre Aufgabe: Erstellen Sie diesen Plot mit Python nach.
Das bedeutet:
- Finden Sie die Daten – programmatisch. Woher stammen diese Daten eigentlich? Vom Stack Overflow Data Explorer, der Stack Exchange API oder einer anderen Quelle? Ein Teil der Challenge besteht darin herauszufinden, wie man auf die Rohdaten zugreift – und idealerweise Python-Code zu schreiben, der die Daten für Sie abruft, anstatt sie manuell herunterzuladen.
- Reproduzieren Sie den Plot. Schreiben Sie ein Python-Skript, das die Daten laedt und ein Diagramm erzeugt, das dem obigen Bild ähnelt – monatliche Fragenzahlen über die Zeit, mit einem gleitenden Durchschnitt.
- Erweitern Sie es. Überlagern Sie Markierungen für bahnbrechende KI-Ereignisse aus der Interaktiven KI-Zeitleiste des Kurses. Besuchen Sie die Zeitleiste, erkunden Sie die Meilensteine und finden Sie einen Weg, die relevanten Daten (Ereignisnamen, Daten) in Ihr Python-Skript einzubringen. Sie wählen das visuelle Design der Markierungen: vertikale Linien, Annotationen, Icons, farbige Bereiche – seien Sie kreativ.
Zwei Dinge fallen bei dieser Challenge auf:
- Sie ist mit generativer KI überraschend machbar. Mit den richtigen Prompts und einem Code-Piloten an Ihrer Seite können Sie schneller als erwartet von Null zu einem funktionierenden Plot gelangen.
- Ohne Anleitung werden Sie auf echte Hindernisse stoßen. Der Datenzugang ist nicht trivial. Parsing-Entscheidungen sind wichtig. Die Plot-Formatierung ist fummelig. KI-generierter Code bringt Sie zu 80% ans Ziel und produziert dann subtile Bugs in den letzten 20%. Achten Sie darauf, wo diese Grenze verläuft.
7.3 Umfrage vor der Challenge
Bevor Sie mit dem Programmieren beginnen, führen wir eine kurze Umfrage durch. Sie werden gebeten einzuschätzen, wie schwierig diese Aufgabe ist und wie lange sie dauern wird – sowohl für ein funktionierendes Skript als auch für ein vollständiges Software-Development-Setup (Projektstruktur, Tests, CI/CD, Dokumentation), das ein Team weiterentwickeln könnte.
Die zentralen Fragen:
- Schwierigkeitsbewertung (1 = trivial, 5 = sehr schwer): Wie schwer schätzen Sie diese Aufgabe ein?
- Zeitschätzung (nur Skript): Wie lange brauchen Sie für ein funktionierendes Python-Skript, das den Plot erzeugt?
- Zeitschätzung (vollständiger SW-Entwicklungszyklus): Wie lange, wenn Sie zusaetzlich eine ordentliche Projektstruktur, Tests, CI/CD und Dokumentation wollen – eine Codebasis, die für Teamarbeit bereit ist?
- Konfidenzniveau (1 = nicht zuversichtlich, 5 = sehr zuversichtlich): Wie zuversichtlich sind Sie, dass Sie die Aufgabe abschließen können?
Fuellen Sie jetzt die Umfrage vor der Challenge aus. Merken Sie sich Ihre Zahlen. Die Kluft zwischen Ihren Schätzungen und der Realität ist eine der wichtigsten Lektionen dieses Kurses.
Nach der Challenge fuellen Sie eine Reflexionsumfrage nach der Challenge aus, damit wir Erwartungen und Realität vergleichen können.
7.4 Challenge-Regeln und Hinweise
Teams: Bilden Sie Gruppen von 2-3 Personen.
Tools: Sie müssen einen Code-Piloten verwenden. GitHub Copilot wird empfohlen (Sie haben es im vorherigen Abschnitt eingerichtet), aber jeder KI-Coding-Assistent ist möglich.
Abgabe: Ein GitHub-Repository mit:
- Python-Code, der das Stack-Overflow-Fragendiagramm reproduziert, einschließlich KI-Meilenstein-Markierungen basierend auf der Interaktiven KI-Zeitleiste des Kurses
- Sie wählen den visuellen Stil der Markierungen – vertikale Linien, farbige Annotationen, beschriftete Pfeile oder alles andere, was die Zeitleiste gut lesbar macht
- Eine Aufzeichnung jedes von Ihnen verwendeten Prompts (siehe unten)
Zentrale Anforderung: Zeichnen Sie Ihre Prompts auf.
Jeder Prompt, den Sie während dieser Challenge einem KI-Tool geben, muss in das Repository eingecheckt werden. Dies ist Ihr erster AI-Diary-Eintrag. Vorerst schreiben wir kein Format vor – finden Sie heraus, was für Ihr Team funktioniert. Speichern Sie Prompts in einer Textdatei, einem Markdown-Dokument, als Screenshots oder in welcher Form auch immer es Ihnen natürlich erscheint. Die einzige Regel lautet: Jemand, der Ihr Repository durchsieht, sollte nachvollziehen können, was Sie die KI gefragt haben und in welcher Reihenfolge.
Warum? Weil Prompts jetzt Teil des Engineering-Prozesses sind. Sie sind Designentscheidungen. Sie verdienen Versionskontrolle genauso wie Code.
7.5 Das AI Diary – Eine Vorschau
Die obige Anforderung zur Prompt-Aufzeichnung ist Ihre erste Begegnung mit einem Konzept, das wir später im Kurs formalisieren werden: dem AI Diary.
Ein AI Diary ist eine systematische Aufzeichnung Ihrer Interaktionen mit KI während der Entwicklung. Es erfasst:
- Was Sie gefragt haben (die Prompts)
- Was Sie erhalten haben (die Antworten, oder zumindest ob sie funktioniert haben)
- Was Sie geändert haben (wie Sie Prompts iteriert haben, die nicht funktioniert haben)
- Was Sie gelernt haben (Muster, die sich herauskristallisiert haben)
Warum ist das wichtig?
- Reproduzierbarkeit: Wenn Ihr Code aufgrund einer bestimmten Prompt-Sequenz funktioniert, ist diese Sequenz Teil Ihres Build-Prozesses.
- Lernen: Die Durchsicht Ihrer eigenen Prompt-Historie offenbart Muster – welche Arten von Anweisungen guten Code produzieren und welche zu Halluzinationen oder Bugs führen.
- Wissensaustausch im Team: In einem Teamkontext sind Prompt-Strategien übertragbares Wissen. Ein AI Diary macht sie teilbar.
- Nachvollziehbarkeit: In professionellen Kontexten wird es zunehmend wichtig, zeigen zu können, wie KI-generierter Code entstanden ist.
Für diese Challenge legen Sie einfach los. Finden Sie einen Ansatz, der sich natürlich anfühlt. Wir werden das AI-Diary-Konzept in einer späteren Vorlesung mit konkreten Vorschlägen, Vorlagen und Werkzeugen für eine systematische Umsetzung erneut aufgreifen.
8. Kursfahrplan: 13 Wochen KI-gestützte Entwicklung
Dieser Kurs folgt einer Vier-Akte-Struktur, bei der jede Phase auf den Fragen aufbaut, die die vorherige aufgeworfen hat:
ExperienceWeeks 1–2
UnderstandWeeks 3–7
MasterWeeks 8–10
GovernWeeks 11–13
Akt I: Erleben (Wochen 1-2) – “Das Wow und das Ups”
Sie NUTZEN KI-Tools, bevor Sie sie verstehen. Sie erleben die Leistungsfaehigkeit und die Fehler aus erster Hand. Das erzeugt die kognitive Spannung, die alles Folgende motiviert. Nach diesen zwei Wochen haben Sie eine persönliche Liste von “Dingen, die die KI richtig gemacht hat” und “Dingen, die die KI falsch gemacht hat” – und eine brennende Frage: Warum?
Akt II: Verstehen (Wochen 3-7) – “Wie funktioniert das eigentlich?”
Der größte Block. Sie lernen die Grundlagen: Tokenisierung, Embeddings, den Attention-Mechanismus, Kontextfenster, Inferenz. Dann lernen Sie, KI-Ausgaben durch Prompting-Strategien und strukturierte Ausgabegenerierung zu steuern. Dies ist das dauerhafte Wissen, das Werkzeugwechsel überlebt. Tools werden kommen und gehen; das Verständnis ihrer Funktionsweise bleibt wertvoll.
Akt III: Meistern (Wochen 8-10) – “Professioneller Einsatz”
Sie lernen, KI-Ausgaben rigoros zu evaluieren (nicht nur “es laeuft”), KI in echte Entwicklungsworkflows zu integrieren (IDE-Assistenten, CI/CD, Code Review), mit agentenbasierten Pipelines zu experimentieren und Produktivitätsauswirkungen mit Daten statt mit Anekdoten zu messen.
Akt IV: Verantworten (Wochen 11-13) – “Das größere Bild”
Sie setzen sich mit Risiken auseinander (Sicherheitslücken in KI-generiertem Code, Prompt Injection, Datenschutz), organisatorischen Auswirkungen (Kosten, Compliance, Schulung) und der Ökonomie der KI-Einführung. Der Kurs endet damit, dass Sie Ihre eigene KI-Integrationsstrategie verteidigen – eine Fähigkeit, die ab dem Moment Ihres Berufseinstiegs wertvoll sein wird.
Erinnern Sie sich an Alex aus der Einführung? In Woche 13 werden Sie nicht nur in der Lage sein, KI-Tools wie Alex zu nutzen – Sie werden wissen, warum die halluzinierte Methode aufgetreten ist (Woche 3: Tokenisierung und Wahrscheinlichkeit), wie man Tests schreibt, die tatsächlich etwas testen (Woche 7: Qualitätsevaluation), warum der Datumsfehler durchgerutscht ist (Woche 5: Prompting für Randfaelle) und wie man einen Workflow aufbaut, der solche Probleme erkennt, bevor sie in die Produktion gelangen (Woche 8: KI in professionellen Workflows).
9. Zusammenfassung
Das haben wir heute behandelt:
-
KI-Coding-Tools sind nicht aus dem Nichts aufgetaucht. Sie sind das Produkt einer jahrzehntelangen Deep-Learning-Revolution, die mit AlexNet (2012) begann, sich mit der Transformer-Architektur (2017) beschleunigte und mit ChatGPT (November 2022) die breite Öffentlichkeit erreichte.
-
Das Tempo des Wandels ist beispiellos. Von ChatGPT zu autonomen KI-Agenten vergingen weniger als drei Jahre. Neue Modelle, Fähigkeiten und Tools erscheinen monatlich. Das Interaktionsparadigma hat sich verschoben – vom Kopieren und Einfügen im Browser hin zu KI-Agenten, die Code in Ihrer Umgebung lesen, schreiben, testen und deployen.
-
Die Auswirkungen auf die Branche sind real und messbar. Der Stack-Overflow-Traffic sank um circa 50%. GitHub berichtet, dass 46% des neuen Codes KI-gestützt entsteht. 76% der Entwickler nutzen KI-Coding-Tools oder planen deren Einsatz. Doch das Vertrauen in die KI-Genauigkeit (43%) hinkt den wahrgenommenen Produktivitätsgewinnen (70%) weit hinterher – und genau in dieser Lücke bewegt sich dieser Kurs.
-
Die Anbieterlandschaft ist komplex und wettbewerbsintensiv. OpenAI, Anthropic, Google, Meta, DeepSeek, Mistral und andere haben jeweils unterschiedliche Stärken, Preismodelle und Datenschutzimplikationen. Diese Komplexität ist genau der Grund, warum eine systematische Evaluationsmethodik wichtig ist.
-
Dieser Kurs verwendet VS Code + GitHub Copilot, weil es für Studierende kostenlos, gut integriert, ein Industriestandard und zunehmend modellunabhängig ist. Sie werden aber auch mit anderen Tools und APIs arbeiten, um breite Kompetenz aufzubauen.
-
Ihre erste Challenge setzt das Gelernte sofort in die Praxis um. Das Nacherstellen des Stack-Overflow-Fragendiagramms mit KI-Tools ist eine reale Aufgabe mit realen Hindernissen – Datenzugang, Codegenerierung, Debugging. Das Aufzeichnen Ihrer Prompts in einem AI Diary ist Ihr erster Schritt dahin, KI-Interaktionen als Engineering-Artefakte zu behandeln, nicht als Wegwerf-Konversationen.
-
Das Ziel ist nicht, Sie abhängig von KI zu machen. Das Ziel ist, Sie zu einem KI-kompetenten Ingenieur zu machen, der diese Werkzeuge kritisch evaluieren, effektiv einsetzen und strategisch deployen kann. Die Entwickler, die erfolgreich sein werden, sind nicht diejenigen, die KI-Ausgaben blind akzeptieren, und auch nicht diejenigen, die KI gaenzlich ablehnen – es werden diejenigen sein, die die Technologie tief genug verstehen, um zu wissen, wann man ihr vertrauen und wann man sie hinterfragen sollte.
Nächste Woche analysieren wir die Ergebnisse der Stack-Overflow-Challenge. Welche Prompts haben beim ersten Versuch funktionierenden Code produziert? Wo hat die KI gestrauchelt? Wie haben sich Ihre Zeitschätzungen im Vergleich zur Realität geschlagen? Die Muster von Erfolg und Misserfolg dieser Challenge beginnen die Reise von der Erfahrung zum Verständnis.
10. Weiterführende Literatur
Grundlegende Arbeiten:
- Krizhevsky, Sutskever, Hinton. “ImageNet Classification with Deep Convolutional Neural Networks” (NeurIPS 2012) – Das AlexNet-Paper, mit dem alles begann.
- Vaswani et al. “Attention Is All You Need” (NeurIPS 2017) – Das Transformer-Paper. Wir werden es in den Wochen 3-4 im Detail studieren.
- Brown et al. “Language Models are Few-Shot Learners” (NeurIPS 2020) – Das GPT-3-Paper, das emergente Fähigkeiten demonstrierte.
- Chen et al. “Evaluating Large Language Models Trained on Code” (2021) – Das Codex-Paper, das zu GitHub Copilot führte.
Branchenberichte und Umfragen:
- Stack Overflow Developer Survey 2024 (KI-Abschnitte) – Wie Entwickler KI-Tools tatsächlich einsetzen.
- GitHub. “The State of AI in Software Development” (2024) – Copilot-Adoptionsdaten und Produktivitätsbehauptungen.
- Peng et al. “The Impact of AI on Developer Productivity: Evidence from GitHub Copilot” (2023) – Die 55%-Produktivitätsbehauptung, die wir in Woche 10 kritisch untersuchen werden.
Tools und Protokolle:
- GitHub Copilot Dokumentation – Einstieg, Funktionen, Best Practices.
- Anthropic Model Context Protocol (MCP) Spezifikation – Der offene Standard für KI-Tool-Konnektivität.
- VS Code Dokumentation – Extensions, Einstellungen, Tastaturkürzel.
Historischer Kontext:
- Jay Alammar. “The Illustrated Transformer” (jalammar.github.io) – Die beste visuelle Erklärung von Transformern, empfohlene Vorbereitung für die Wochen 3-4.
- Der AlexNet-Moment und seine Auswirkungen: “Deep Learning” von Goodfellow, Bengio und Courville (MIT Press, 2016) – Kapitel 1 für den historischen Kontext.